
La seudonimia como propiedad del modelo de datos
Los estudiantes son seudónimos para los evaluadores. El modelo de datos y la API aplican esa separación, manteniendo la identidad del estudiante fuera del flujo de corrección del evaluador.
Caso de estudio · Ene – Dic 2025
Un monolito heredado en CakePHP y jQuery, reconstruido como una plataforma API-first que hoy ejecuta exámenes de alta exigencia en cinco instituciones nacionales argentinas.
5
instituciones en producciónUNS, UNRN, UNC, UNVM y FAMFyG.
1.000+
usuarios simultáneosObservados en producción con consistencia completa de datos, no en un benchmark sintético.
<300 ms
endpoints críticosLatencia promedio, mediante SQL tuning, caché Redis y colas.
10 / 10
proyecto finalCalificado en la Universidad Nacional del Sur.
Filomena permite preparar, programar, tomar y corregir exámenes en instituciones de ciencias de la salud. Los administradores configuran los exámenes y el acceso, los estudiantes resuelven casos clínicos y los evaluadores corrigen las respuestas con rúbricas estructuradas.
El producto reúne esos flujos, separa los datos de cada institución y protege la identidad del estudiante durante la corrección. La demostración de 43 pantallas recorre las tareas de cada rol dentro de la aplicación.
Las carreras de ciencias de la salud evalúan a sus estudiantes con exámenes escritos masivos y de alta exigencia. La primera versión de Filomena era un monolito CakePHP y jQuery construido para una sola institución. Su rendimiento se degradaba bajo carga concurrente, la toma de exámenes era secuencial, el control de acceso se aplicaba de forma inconsistente y sumar una institución implicaba escribir código.
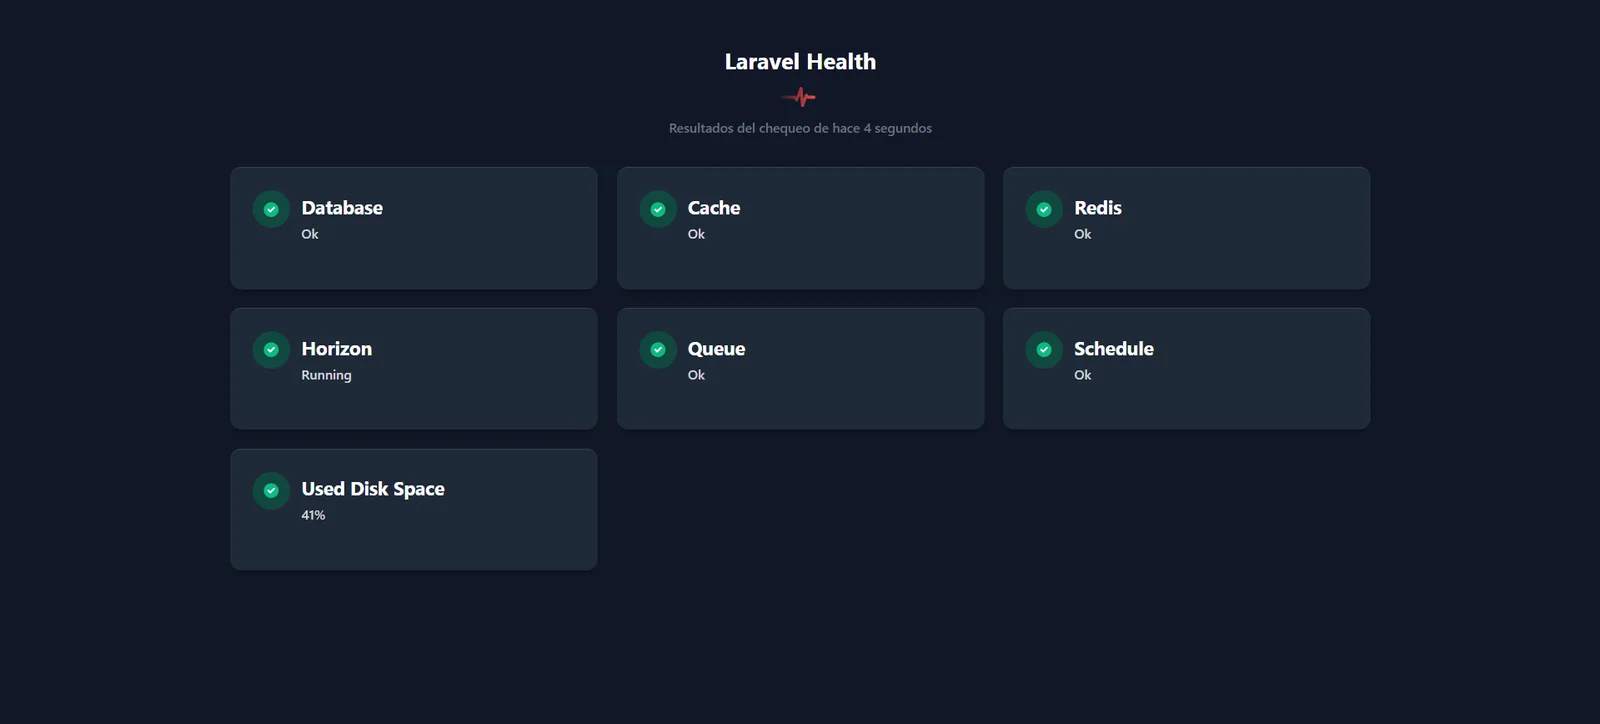
La plataforma original carecía de monitoreo proactivo. La reconstrucción incorporó visibilidad sobre el rendimiento de la aplicación y los servicios que sostienen los exámenes.
Tres roles con necesidades genuinamente distintas. Los administradores configuran instituciones, cursos y cronogramas. Los evaluadores redactan preguntas y revisan resultados. Los estudiantes rinden los exámenes y deben permanecer anónimos ante el evaluador que los califica.
Esos roles no son mutuamente excluyentes. Un profesor puede ser evaluador en un curso y administrador en otro, y por eso el manejo de roles tuvo que ser multirol desde el principio, en lugar de un único campo en el usuario.
Fui el autor y contribuidor principal de un equipo de tres personas para el proyecto final de la Universidad Nacional del Sur. Mi trabajo abarcó arquitectura, backend, frontend, infraestructura, seguridad, observabilidad y coordinación.
Trabajamos de forma iterativa con prácticas Agile y Trello, conectando los requisitos institucionales con la implementación de un producto funcional.
Separamos el monolito CakePHP y jQuery en una API REST Laravel y un frontend Next.js, React y TypeScript. La API estableció un contrato común para la interfaz y los flujos entre instituciones, con validación de entradas y control de acceso por roles. El renderizado del lado del servidor resolvía la carga inicial, seguido por los flujos interactivos de la aplicación.
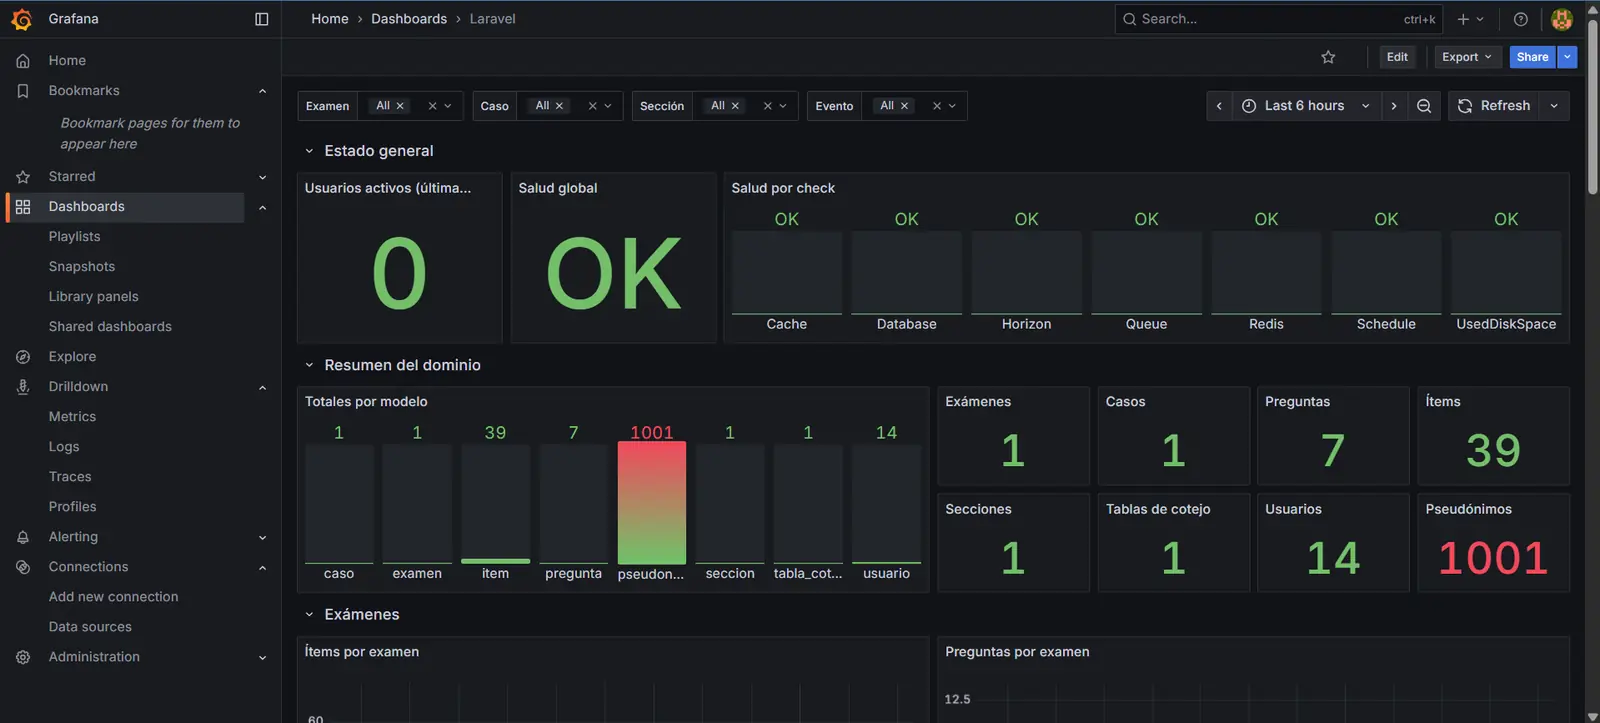
El tuning SQL, los índices, la caché Redis y las colas sostuvieron los flujos de exámenes concurrentes. Prometheus y Grafana permitieron observar el comportamiento de la aplicación y sus servicios en producción.
El recorrido de una solicitud desde el navegador, después de la reconstrucción.
Sistema
43 pantallas de demostración revisadas que recorren administración, exámenes, corrección y monitoreo operativo. Explora los flujos o amplía una pantalla para ver el detalle.
43 / 43
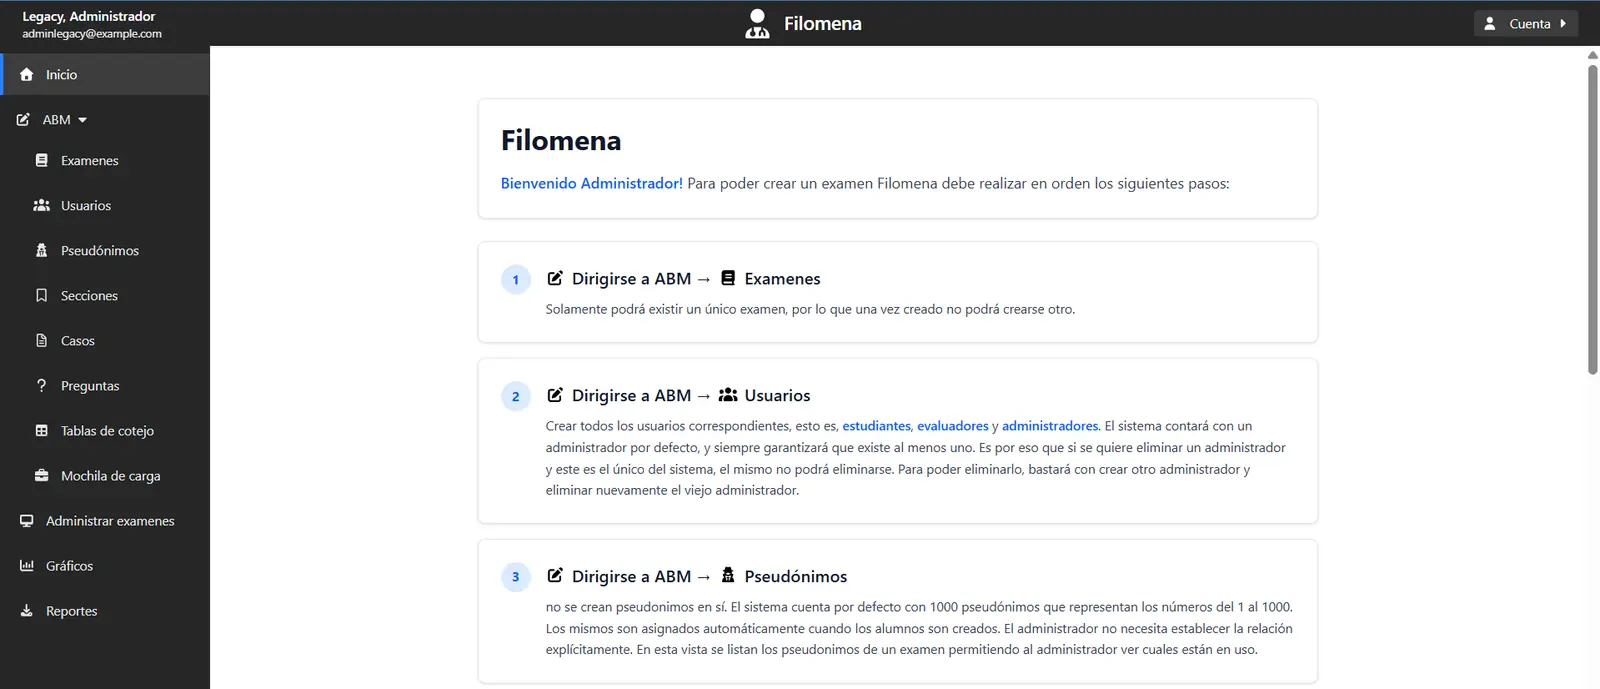
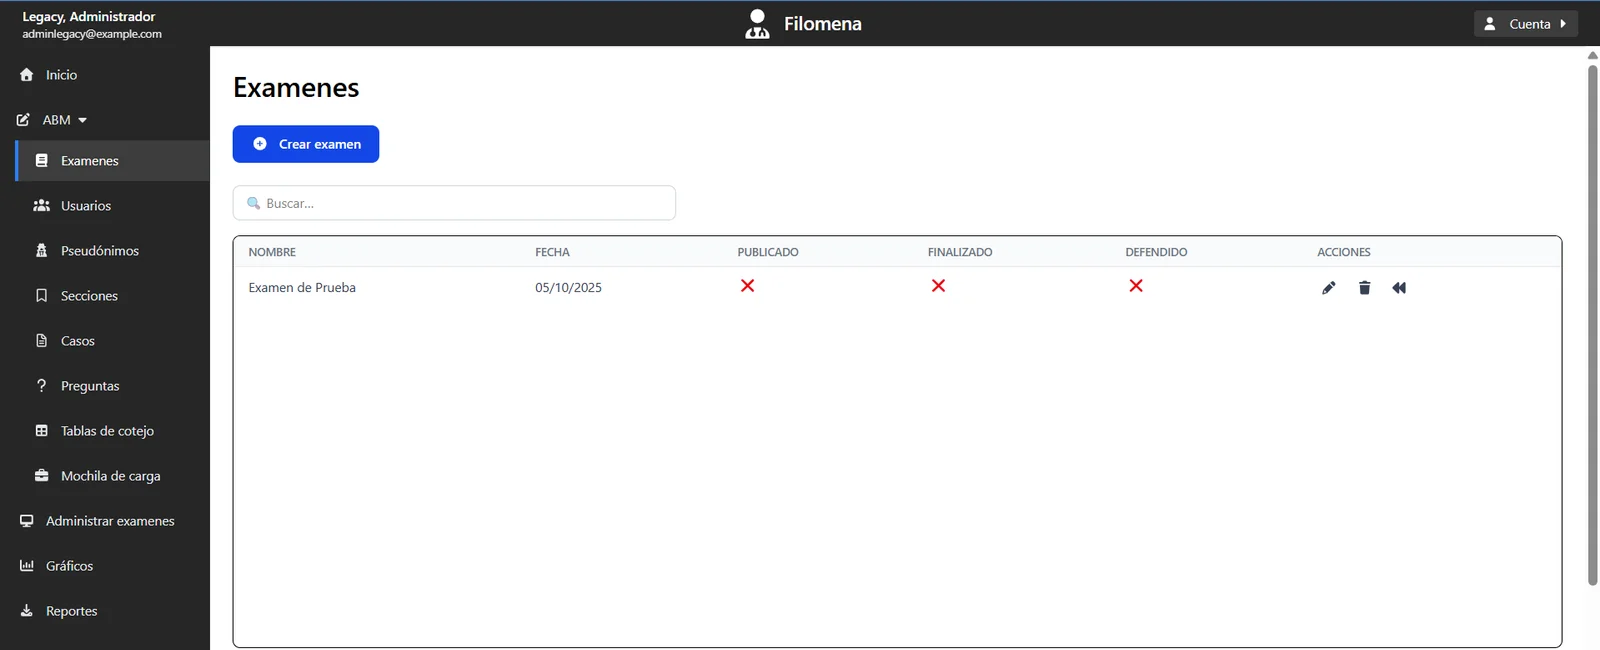
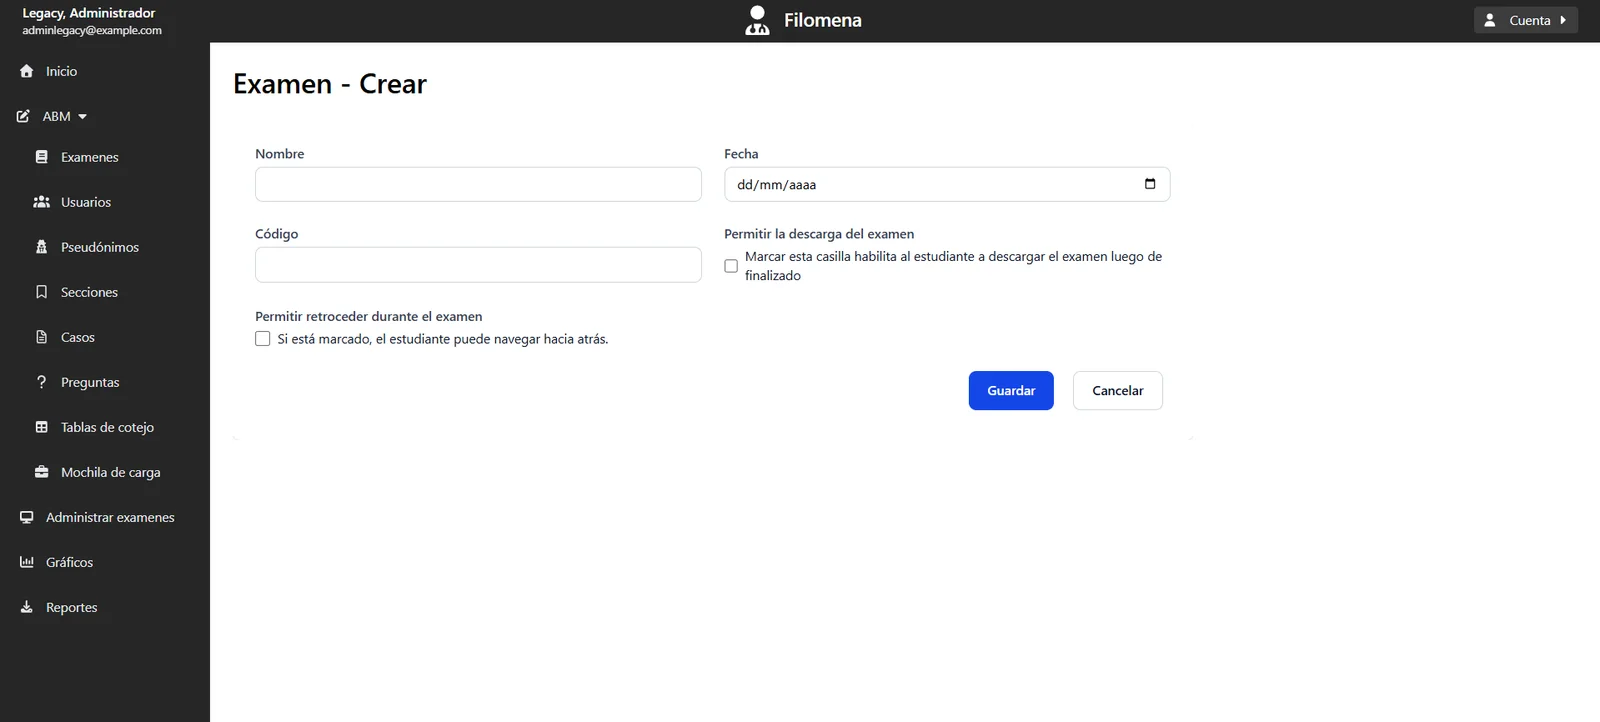
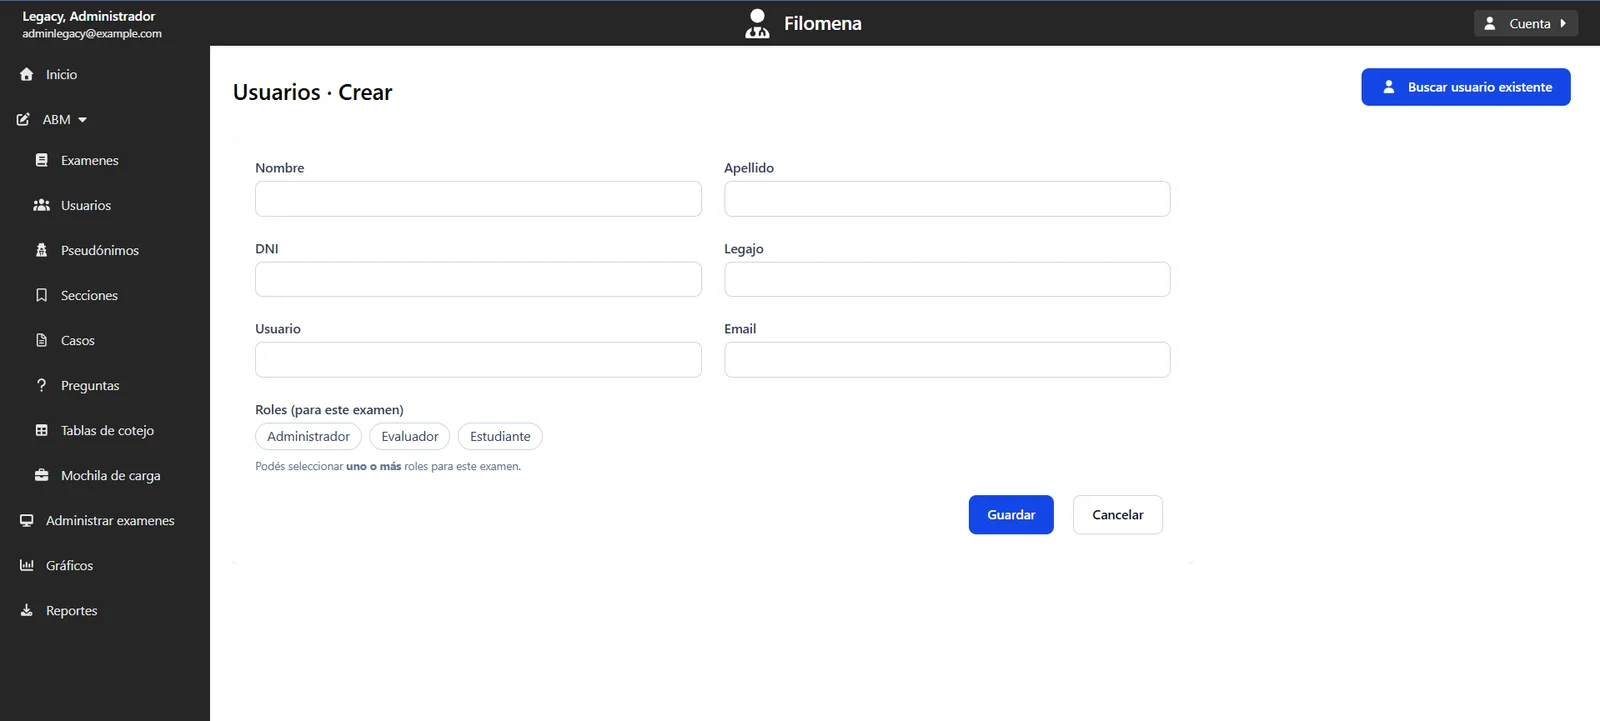
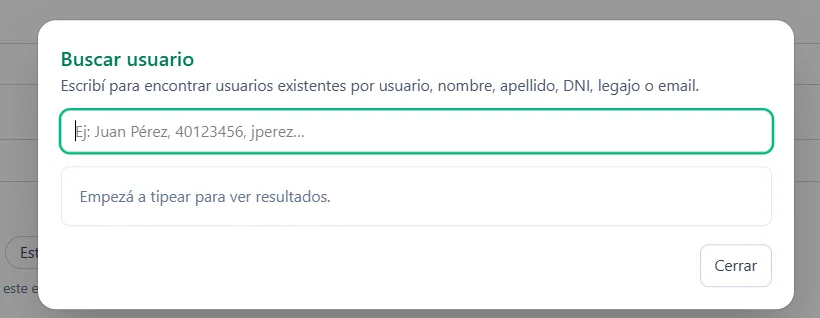
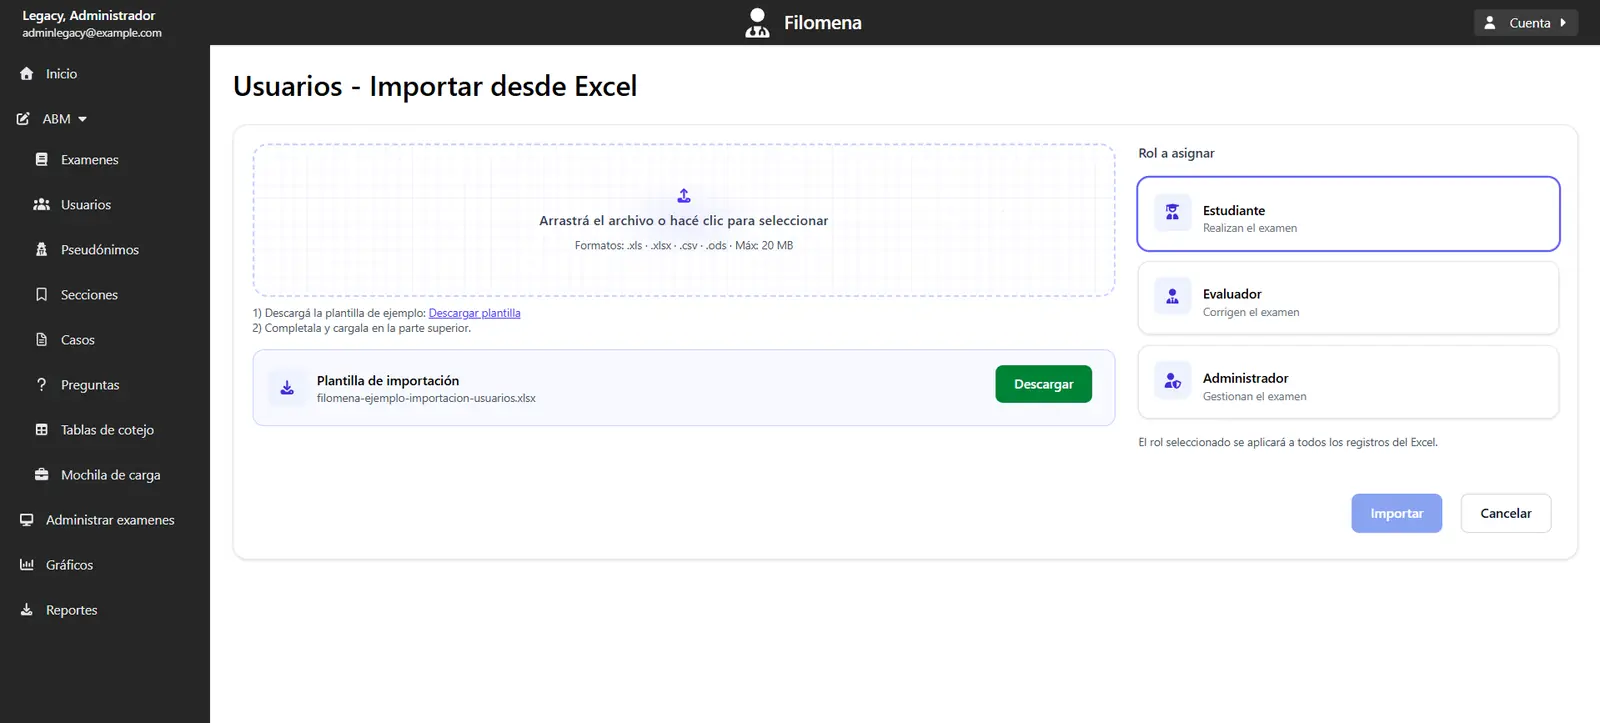
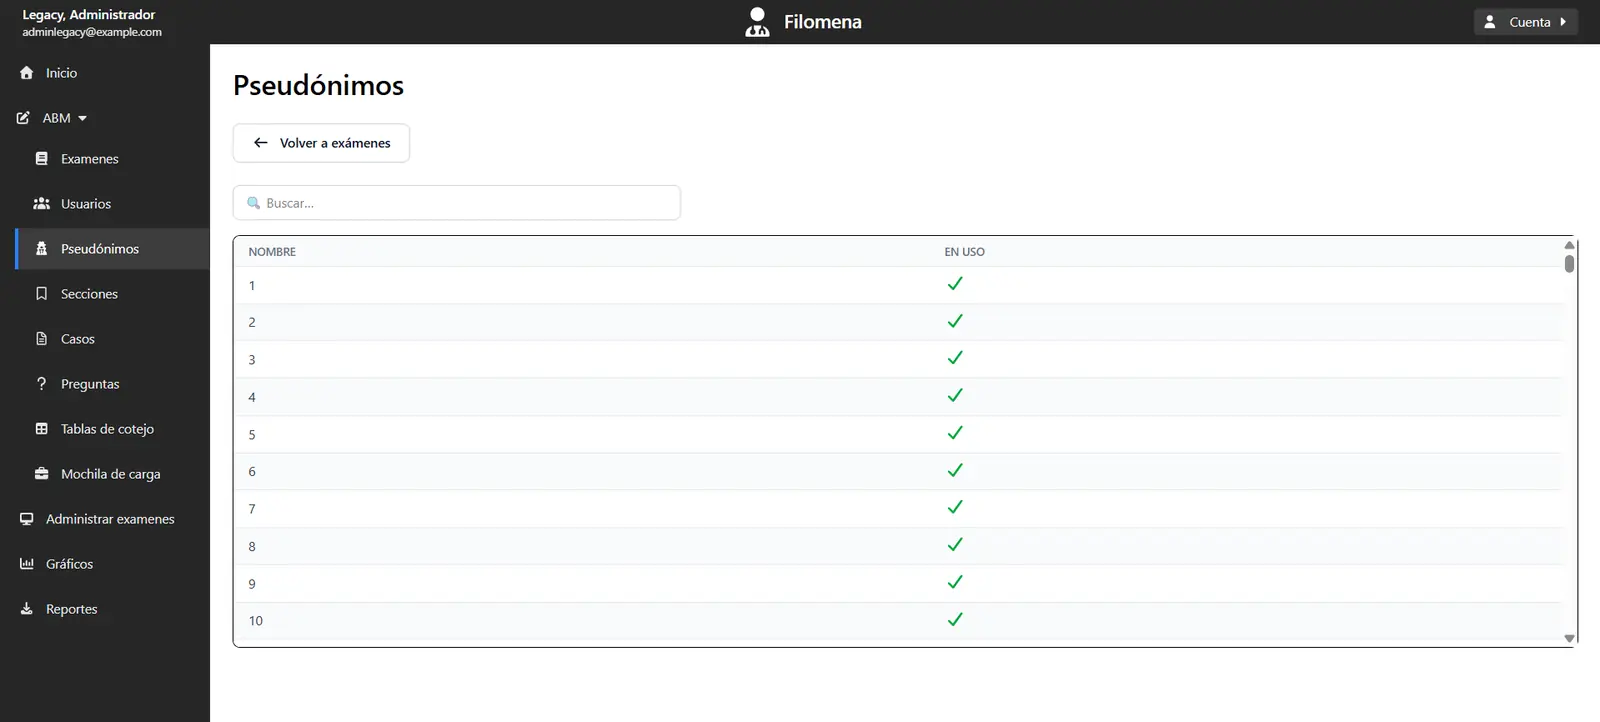
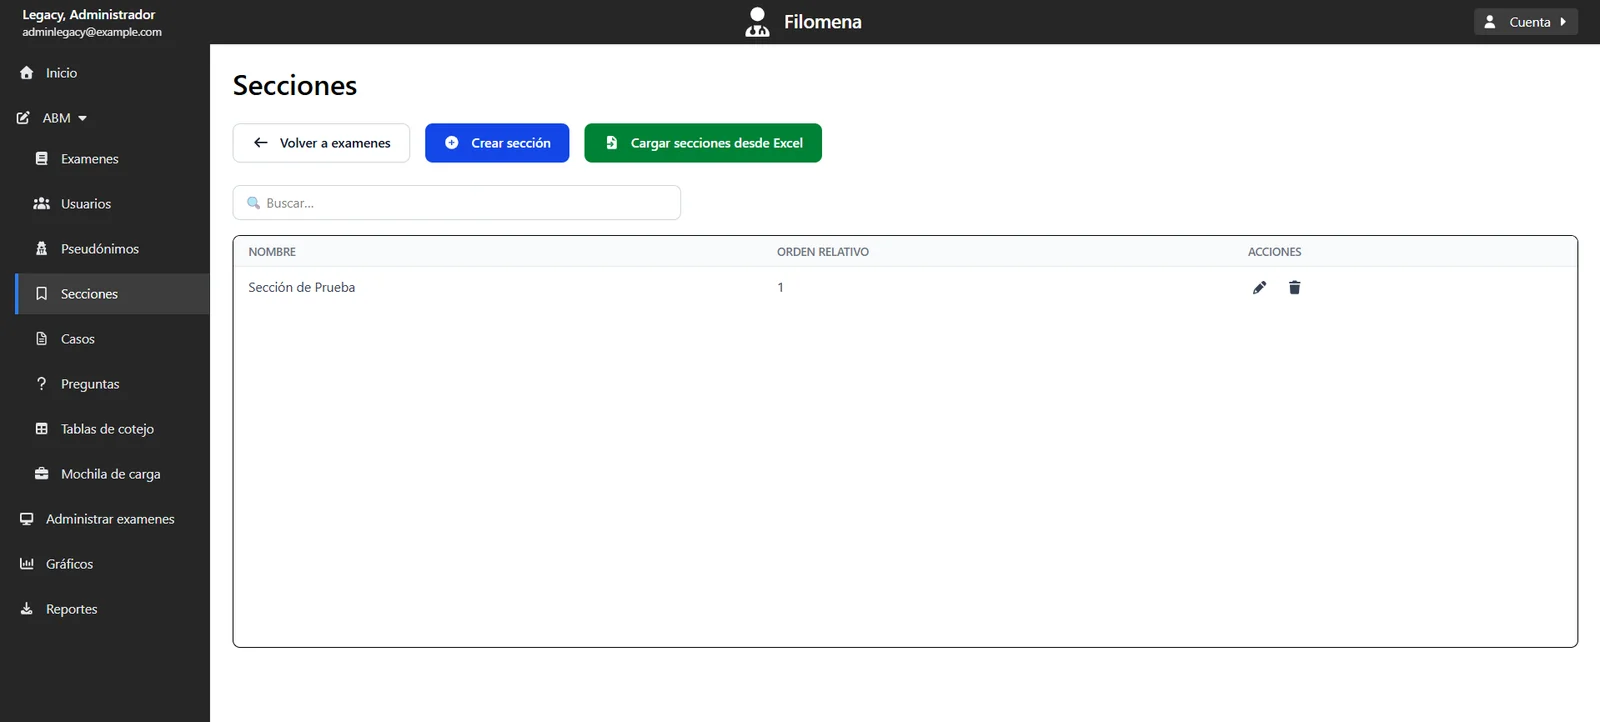
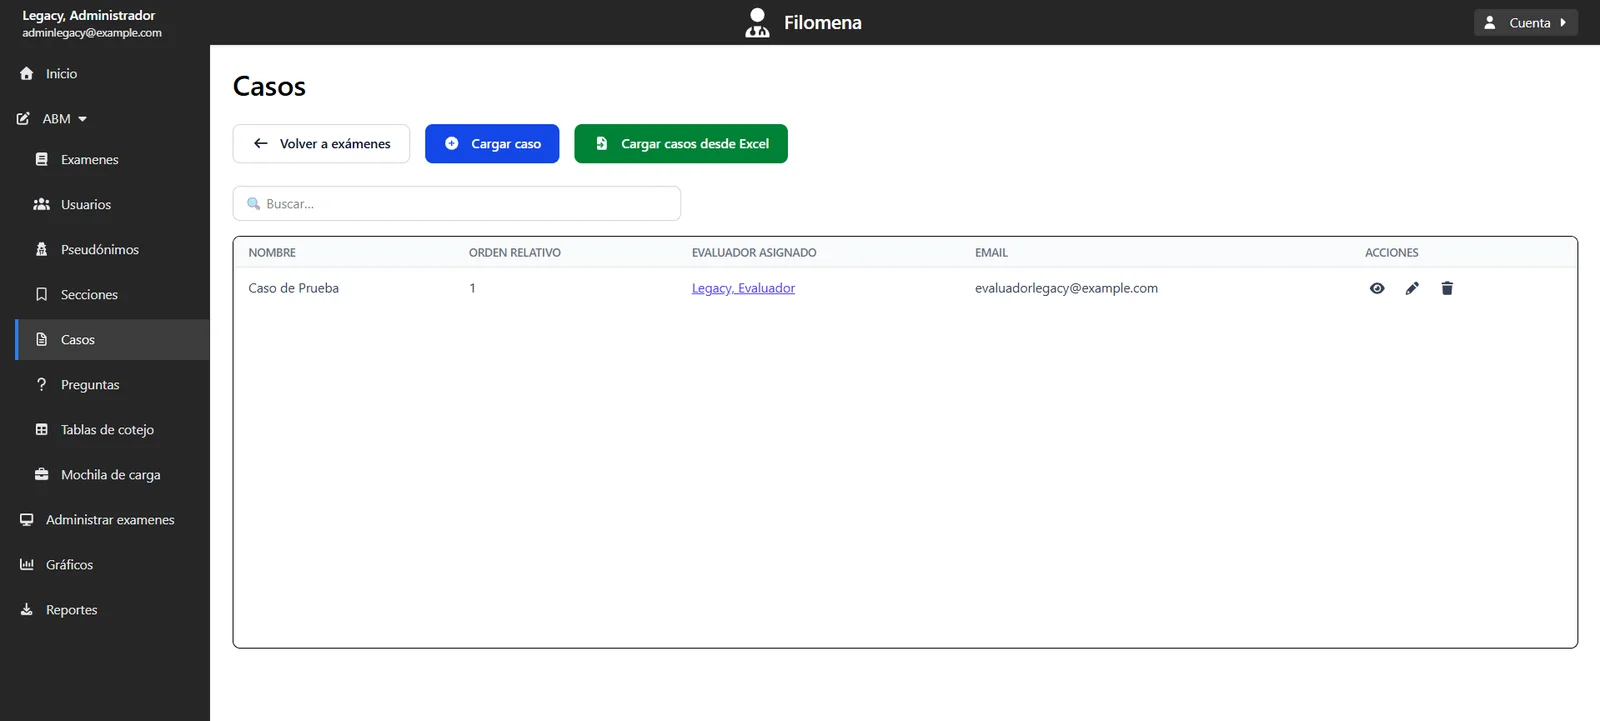
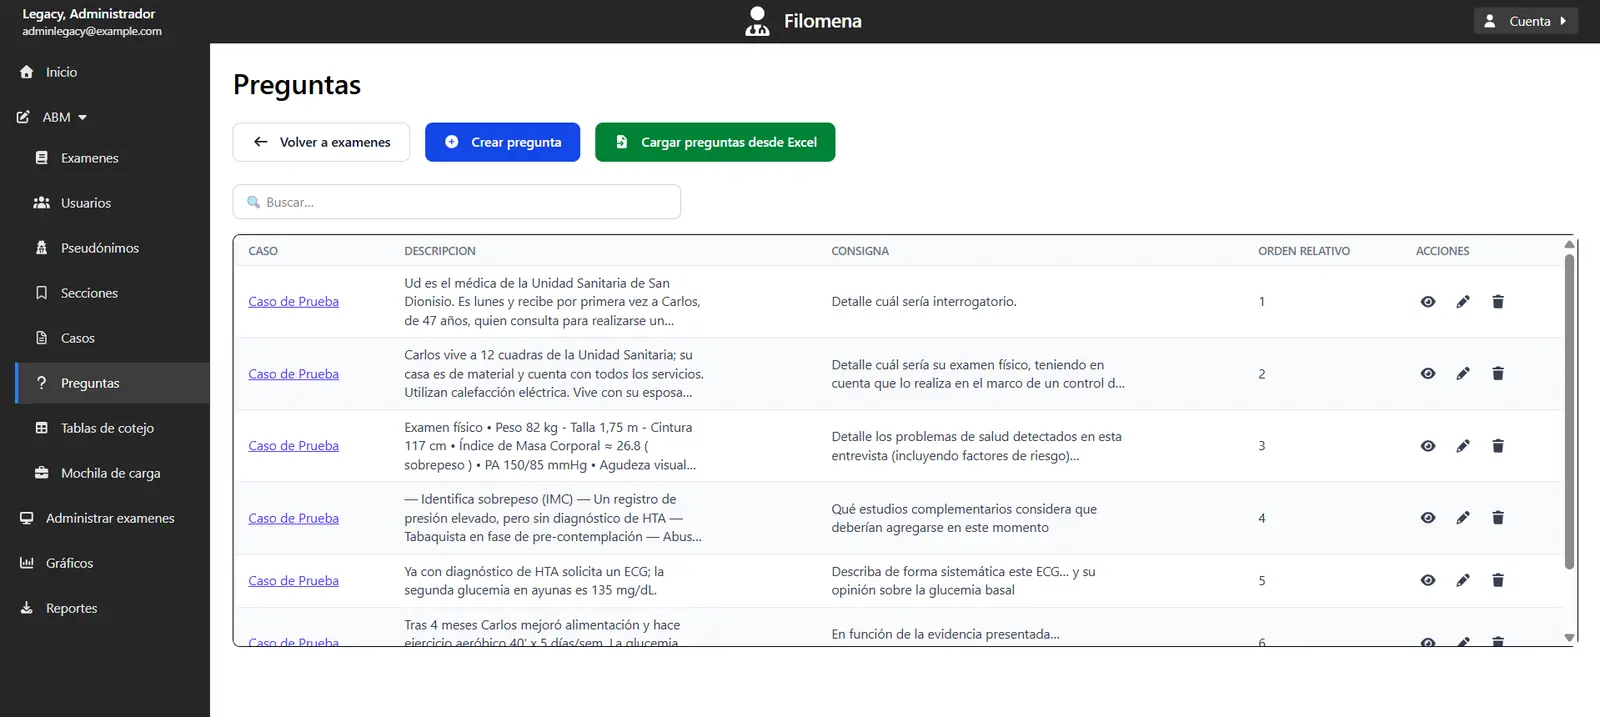
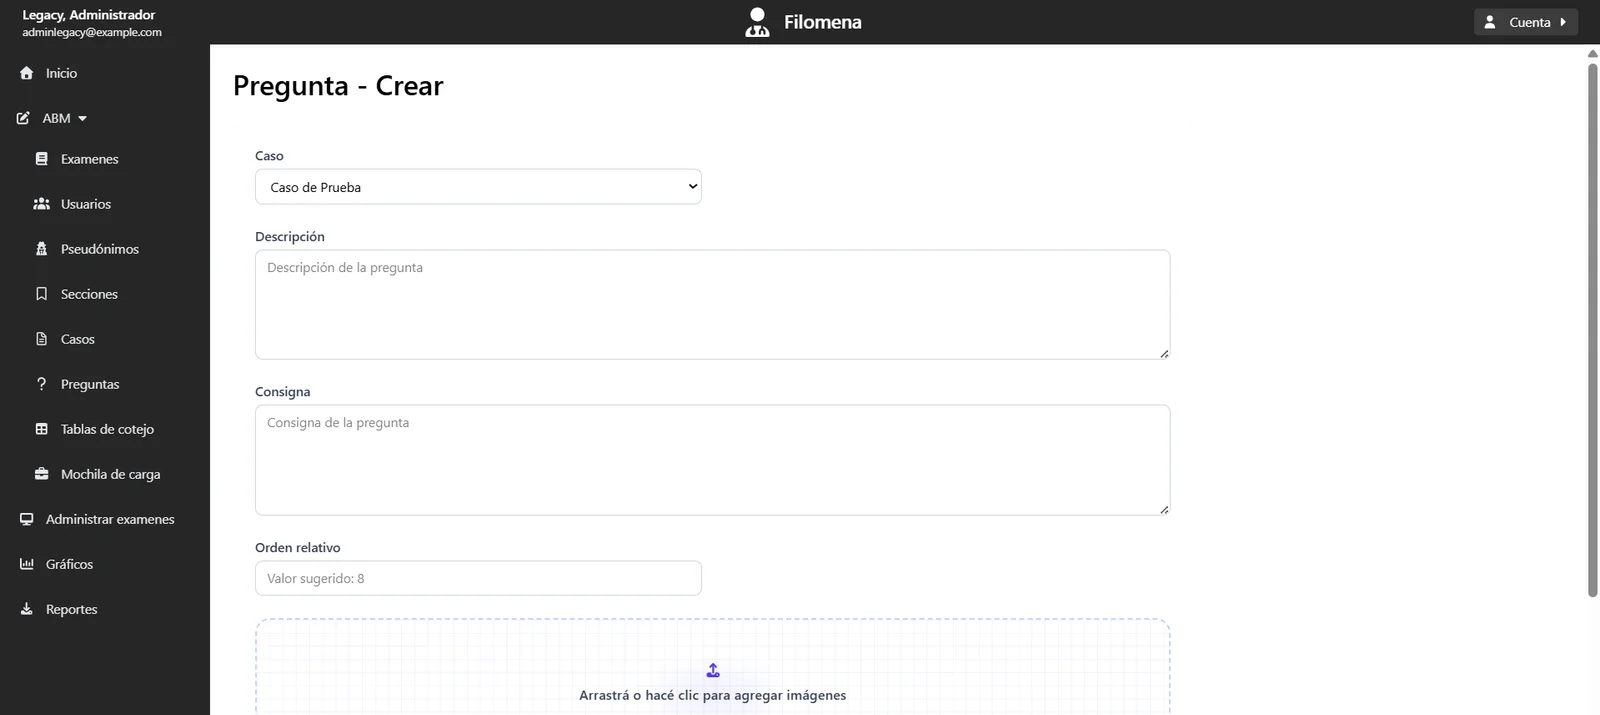
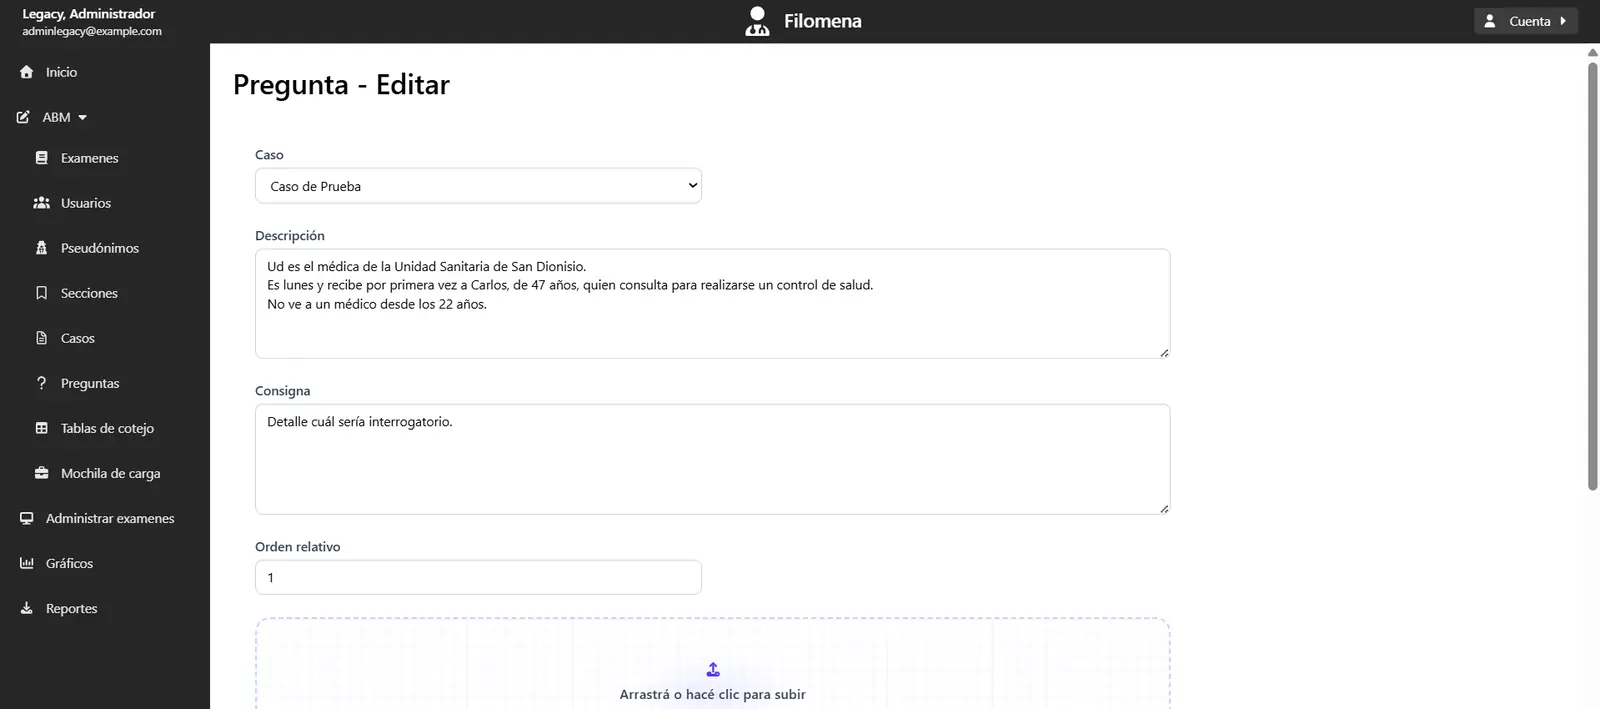
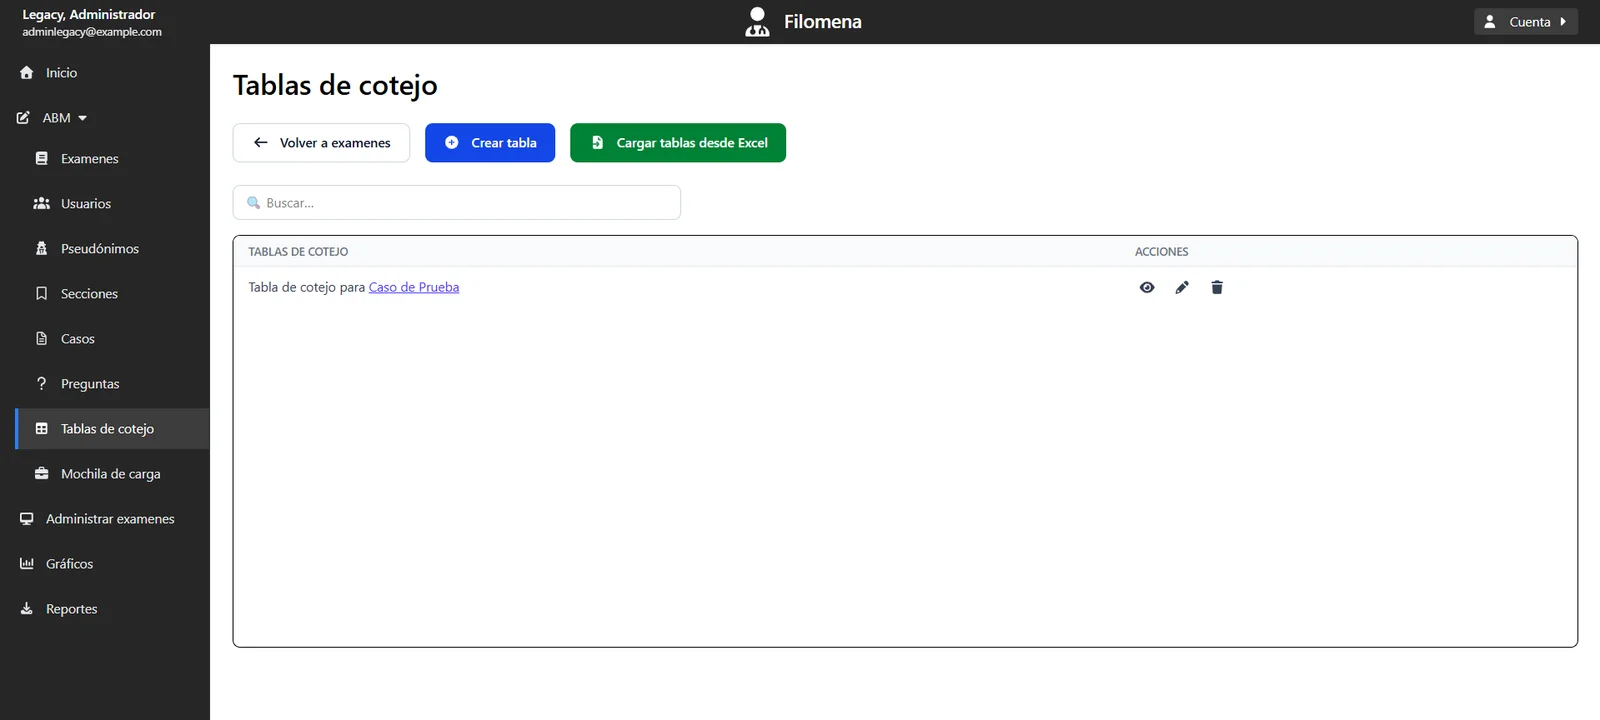
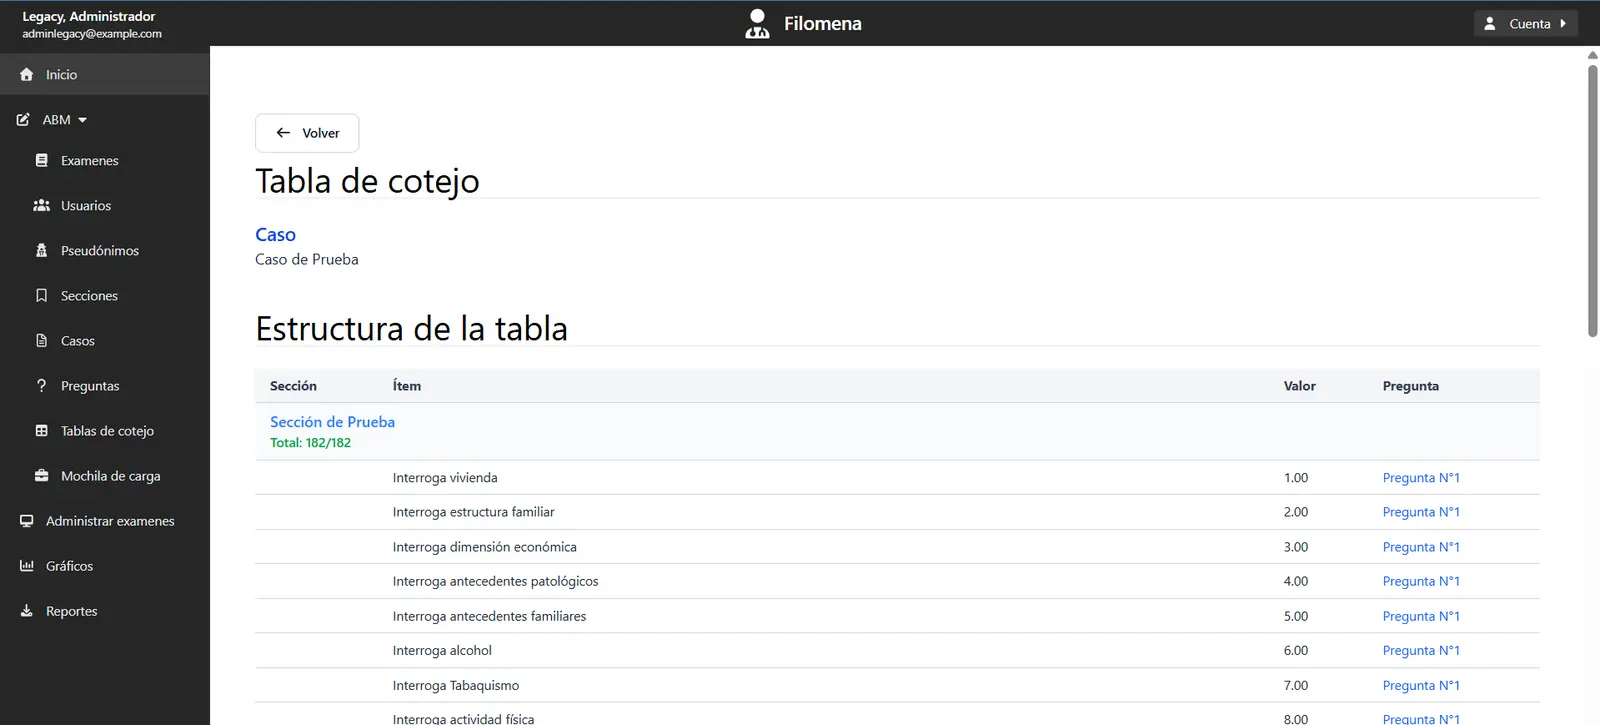
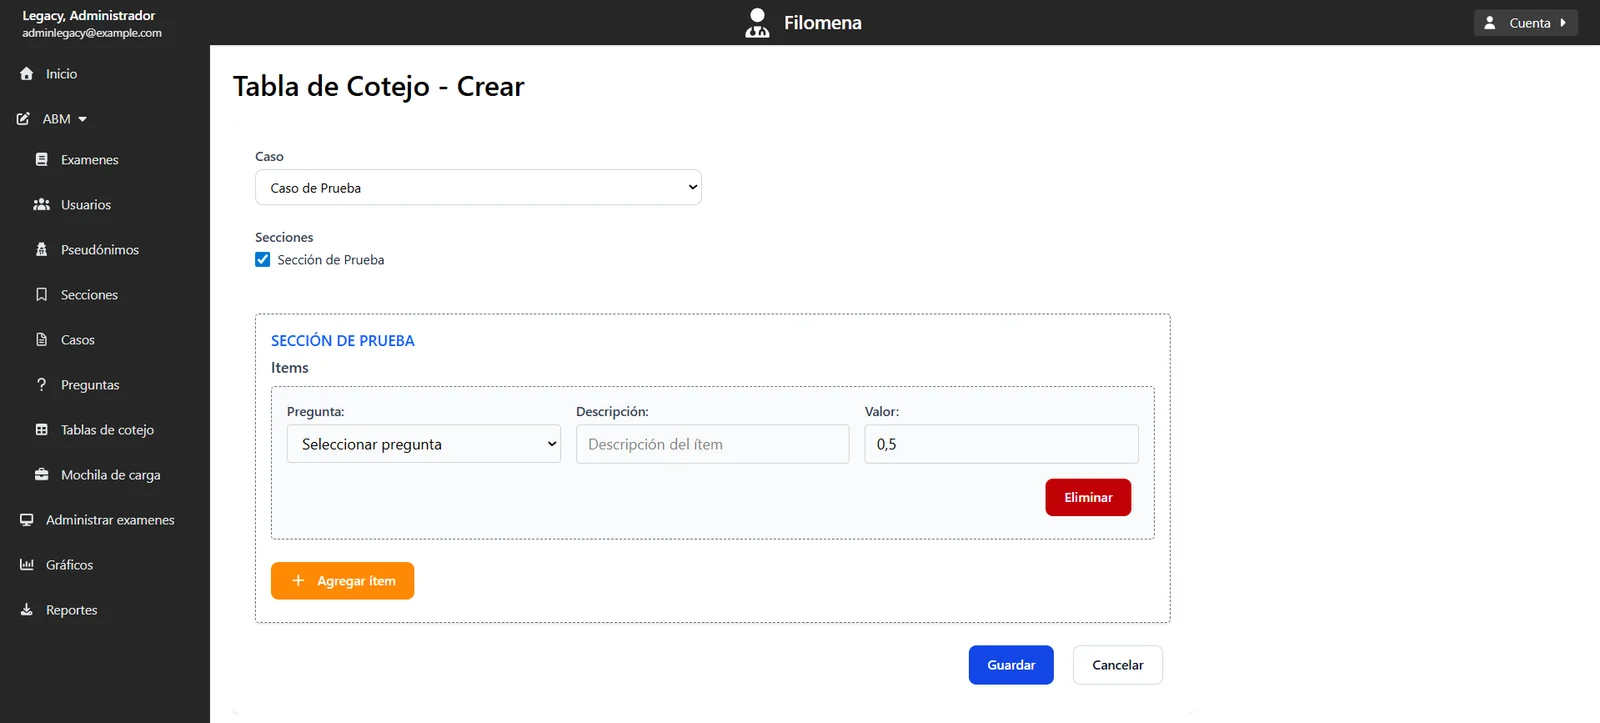
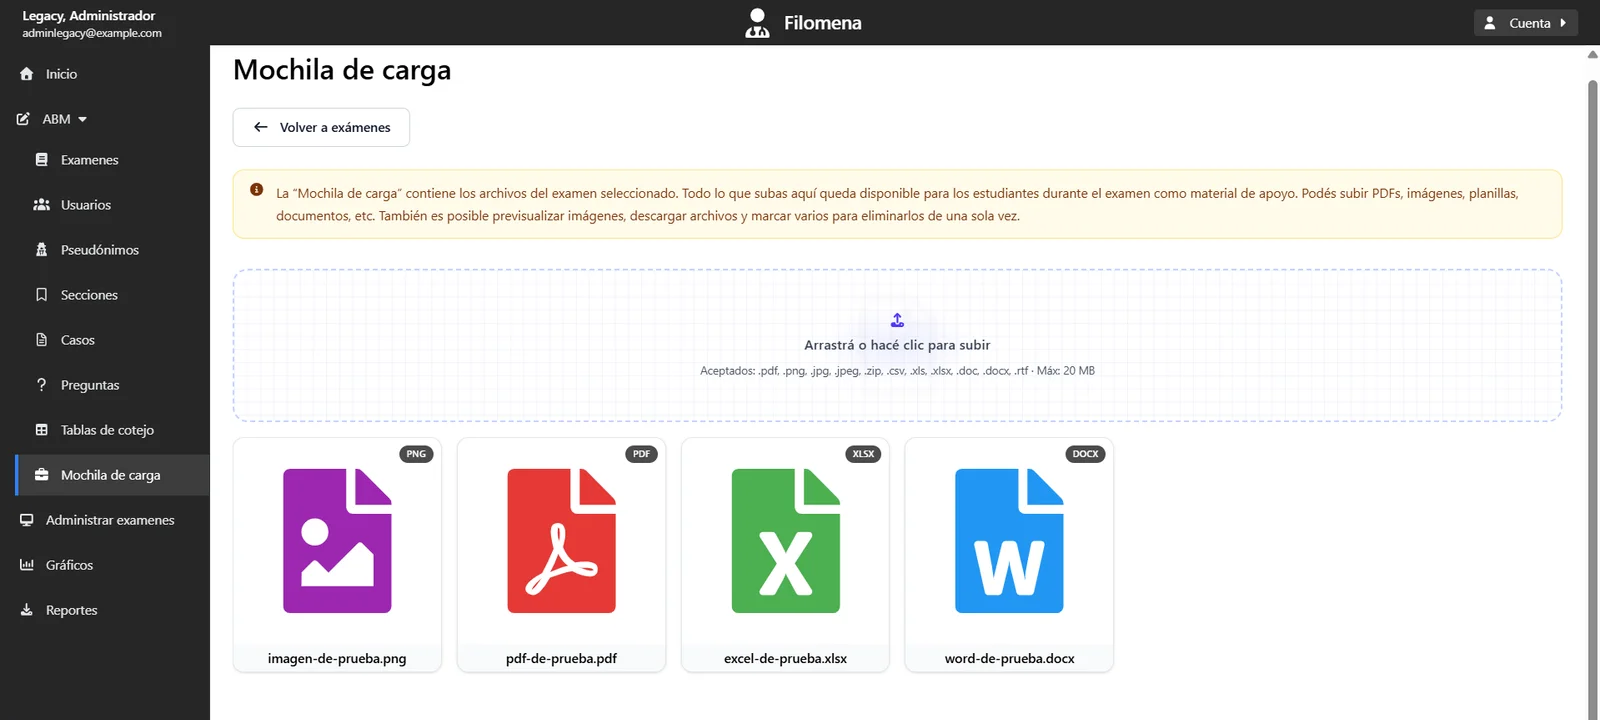
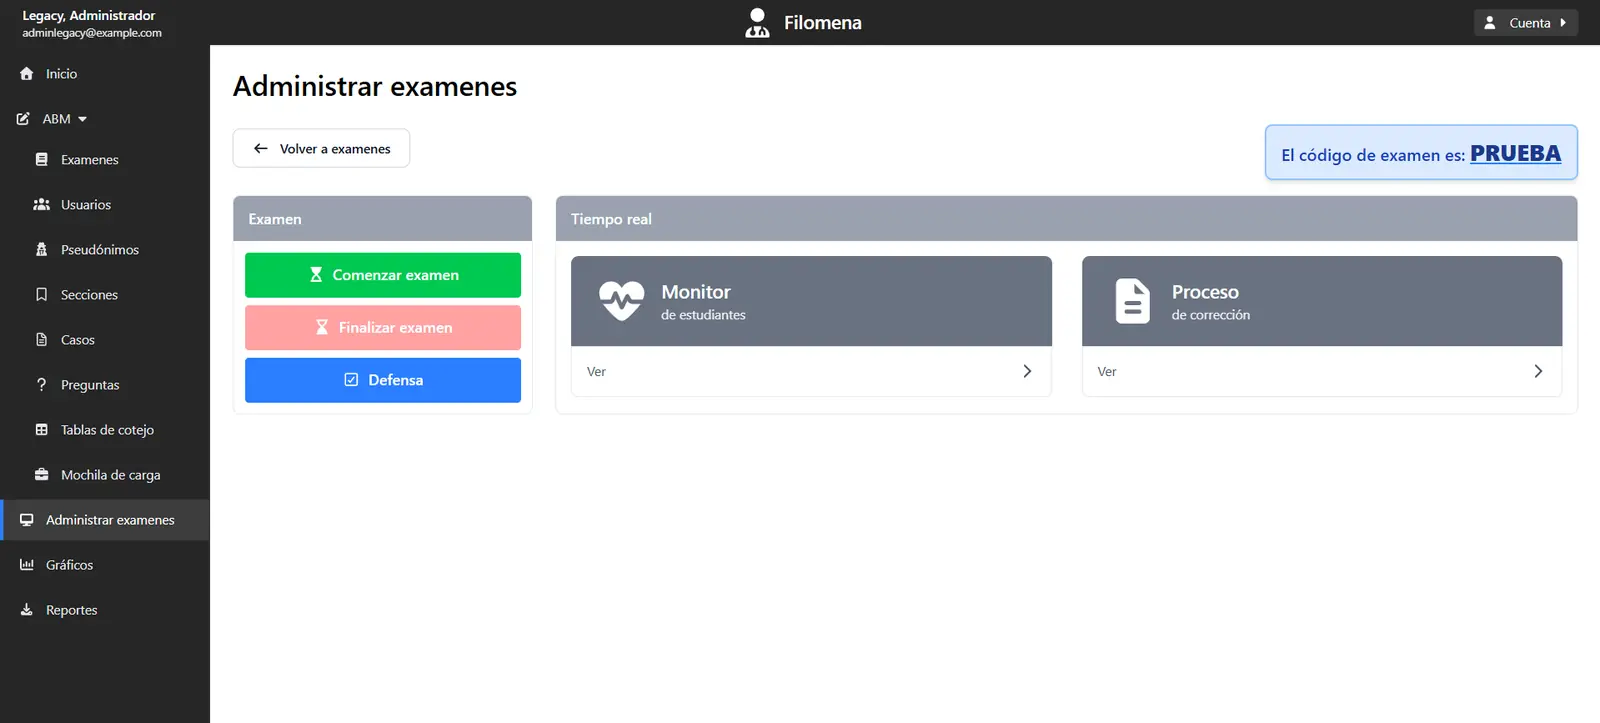
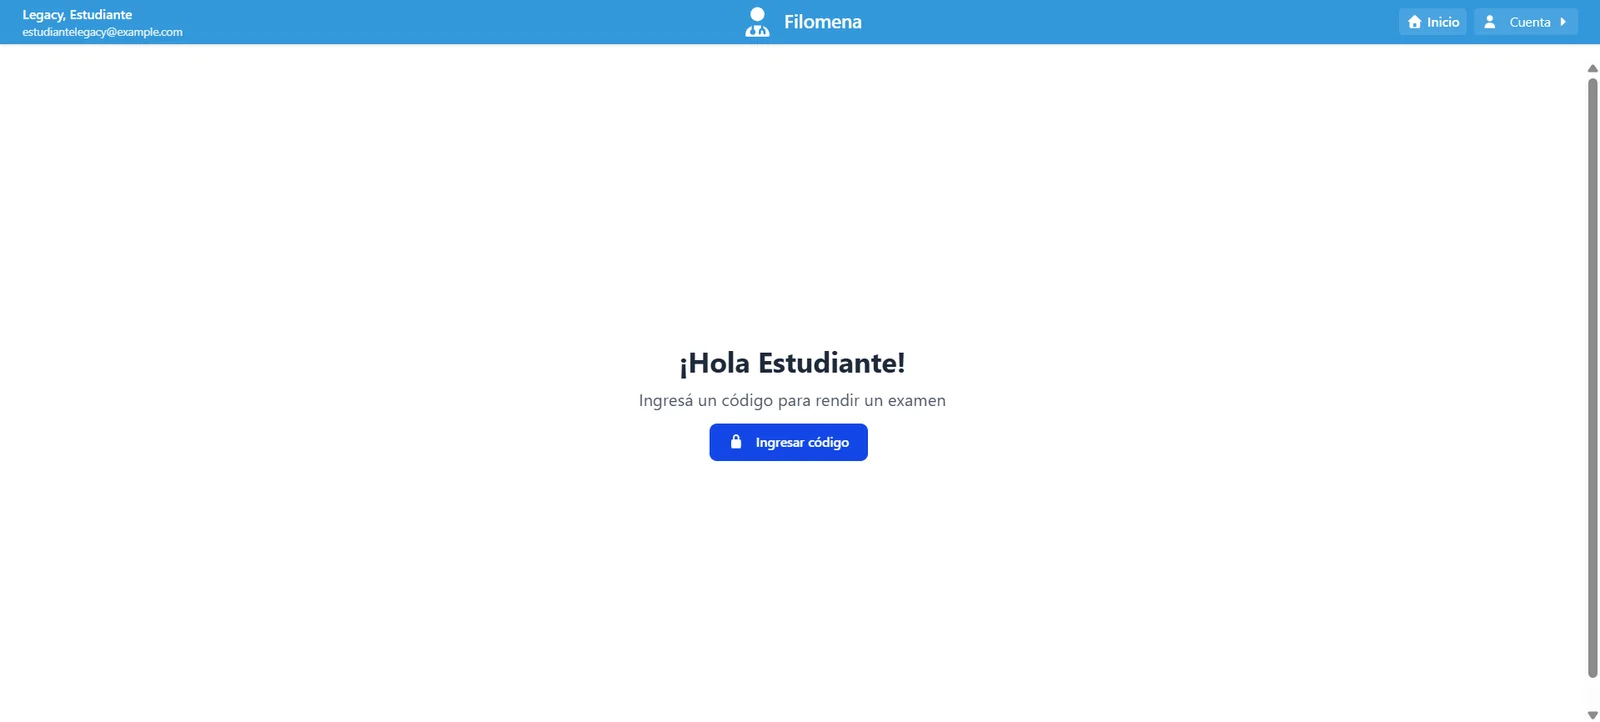
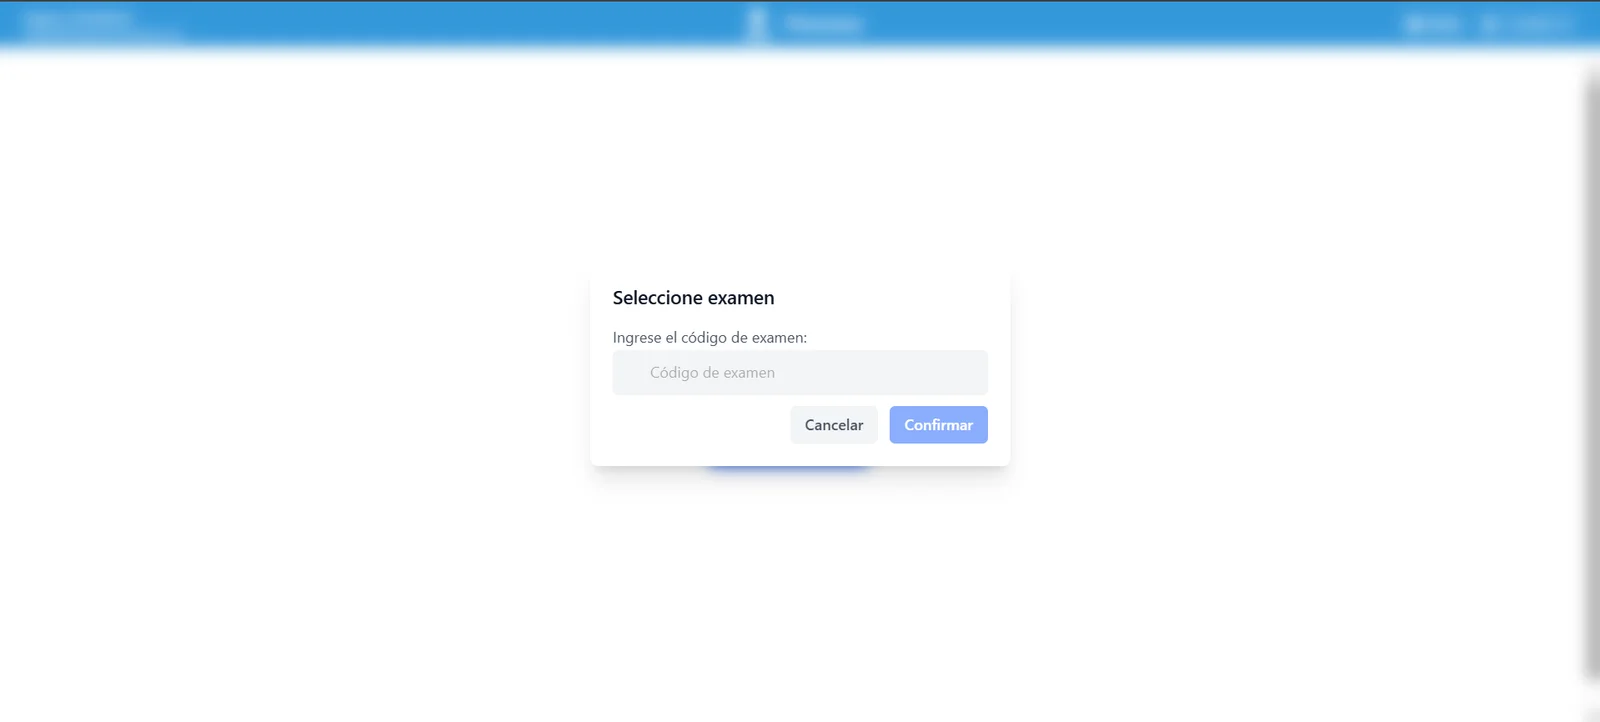
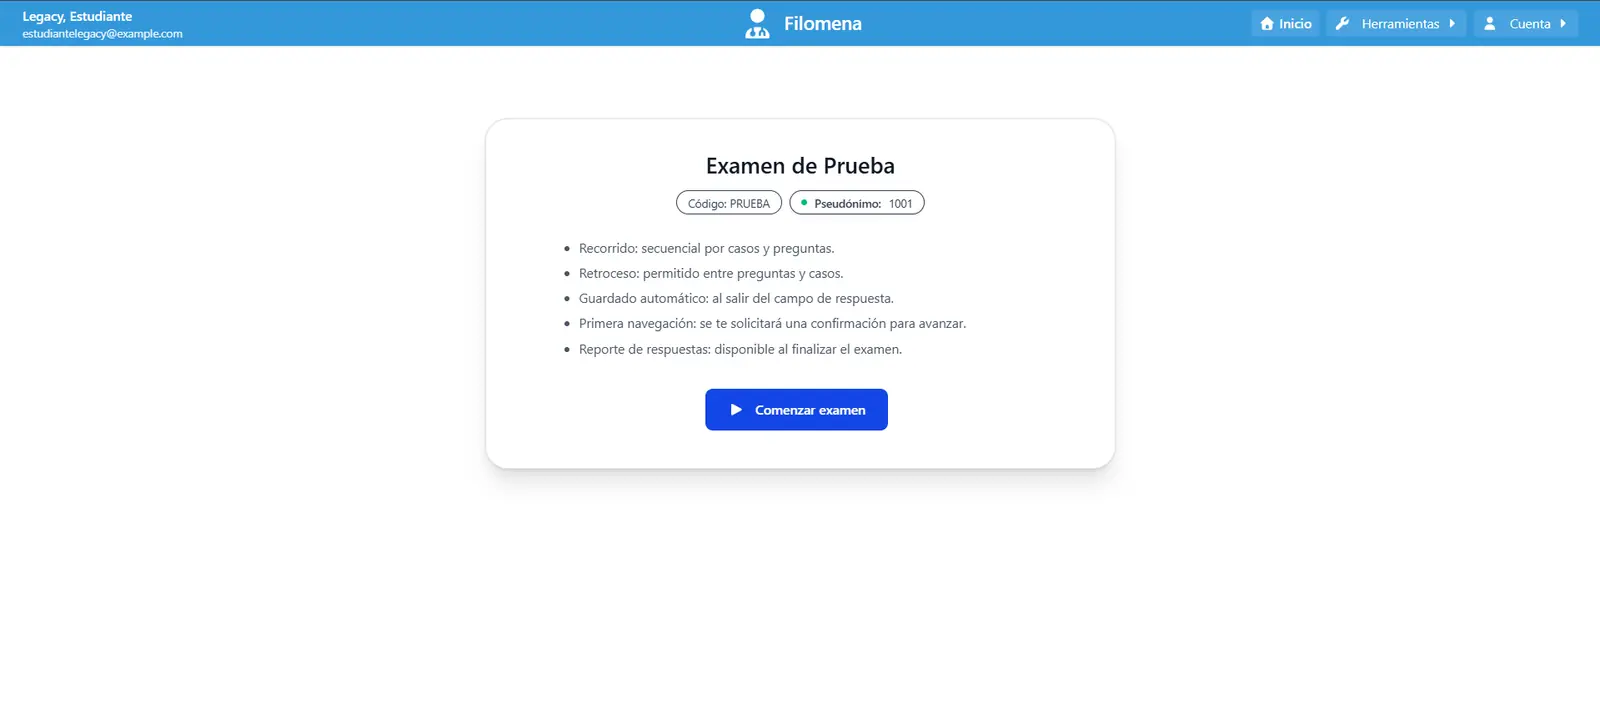
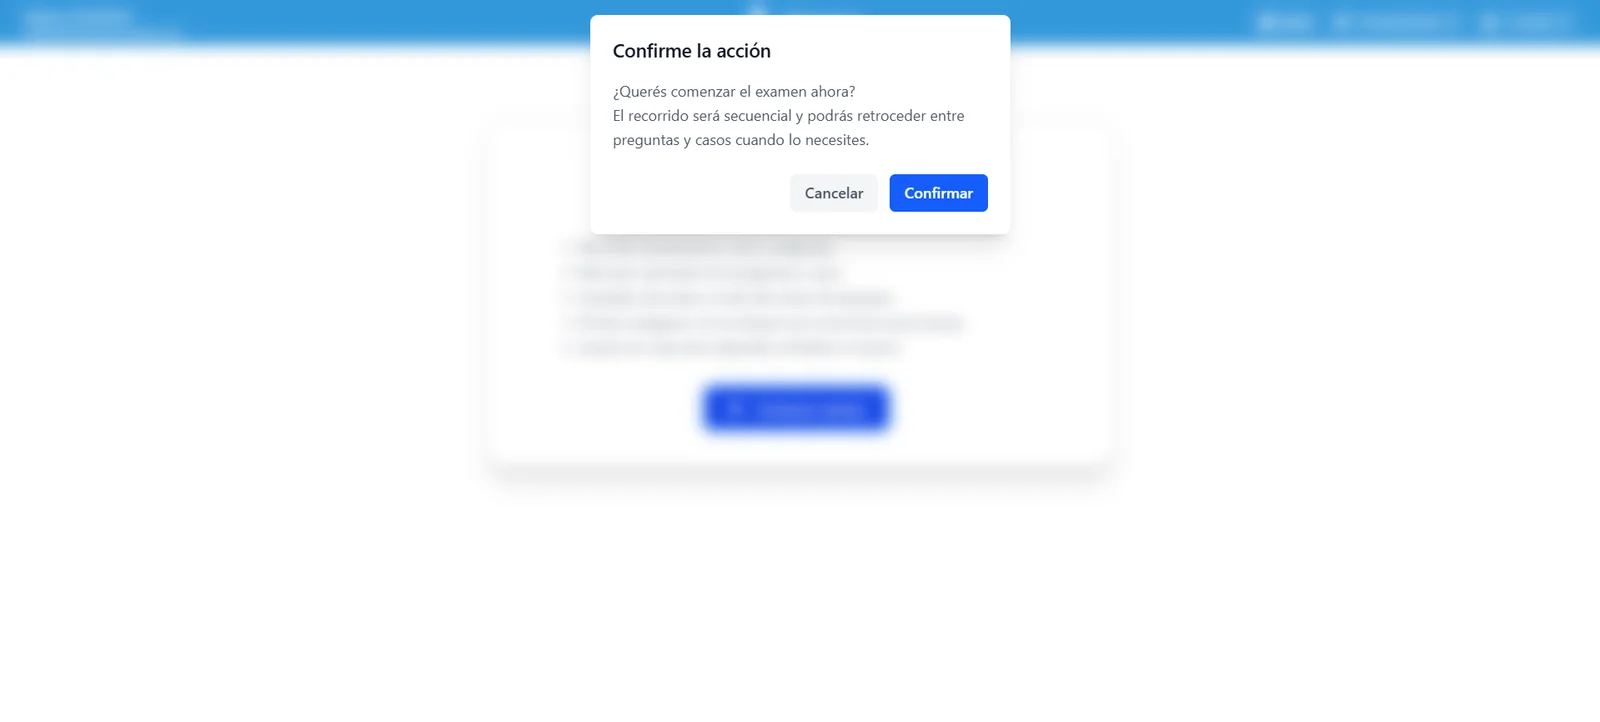
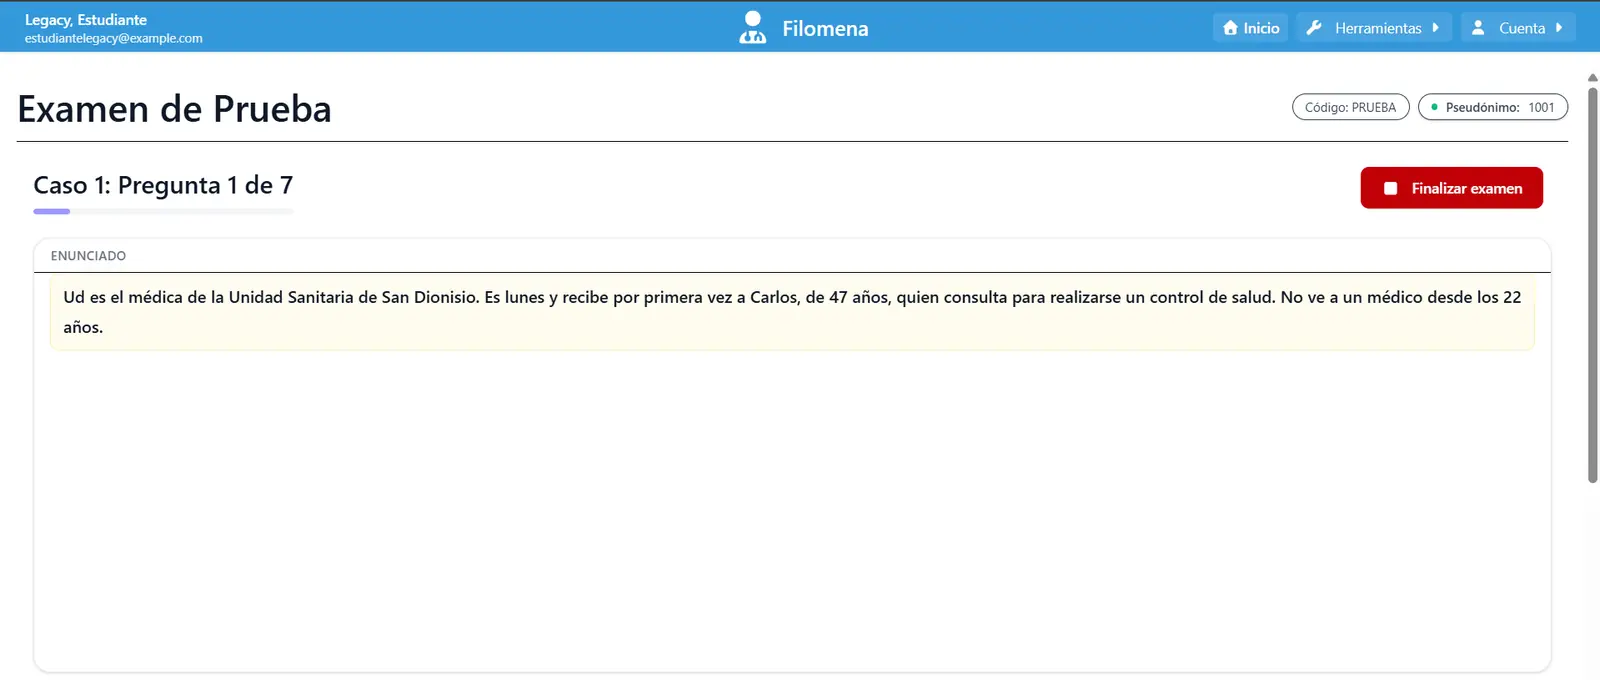
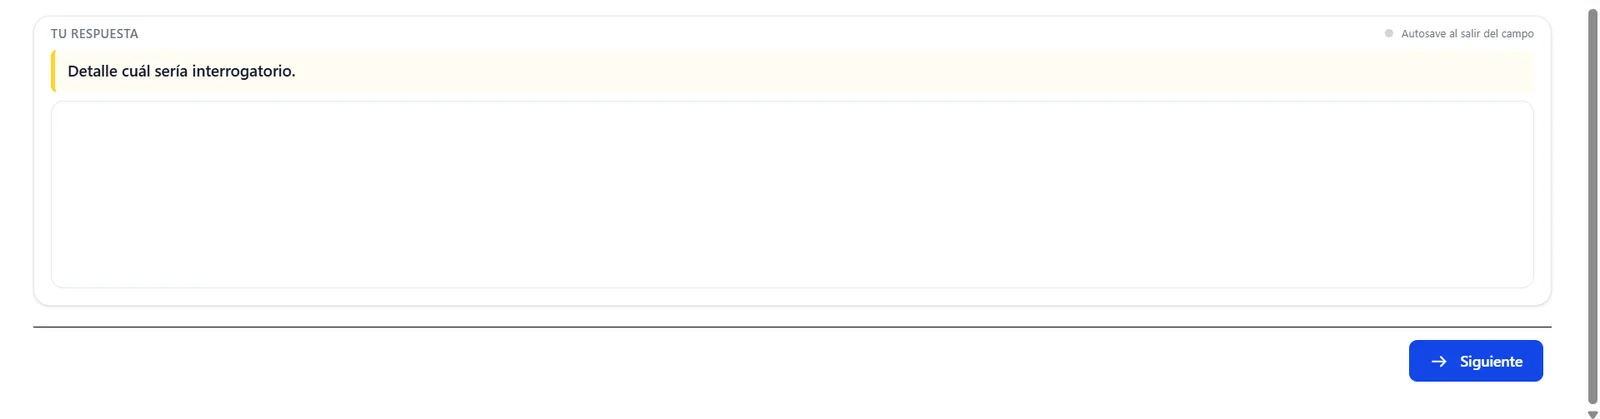
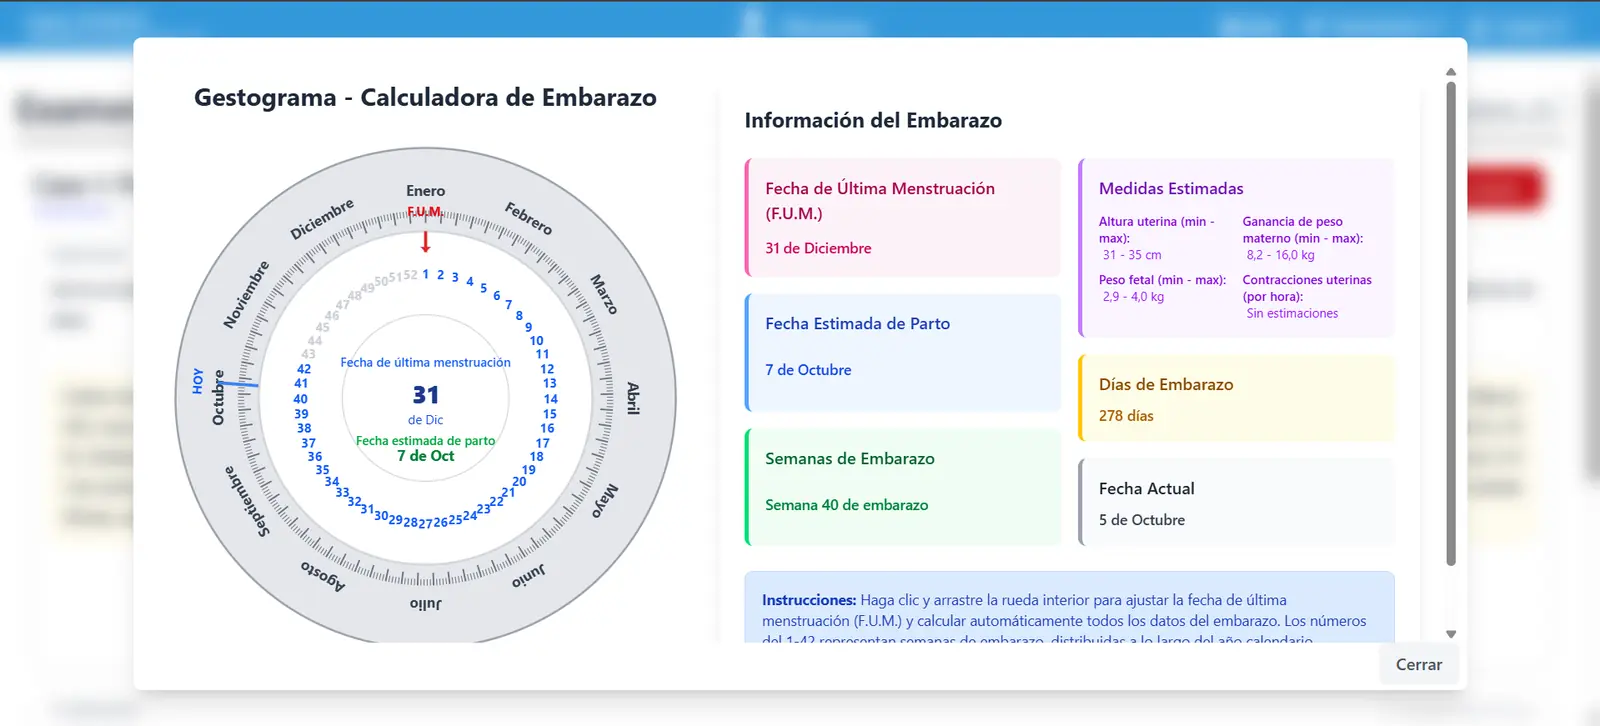
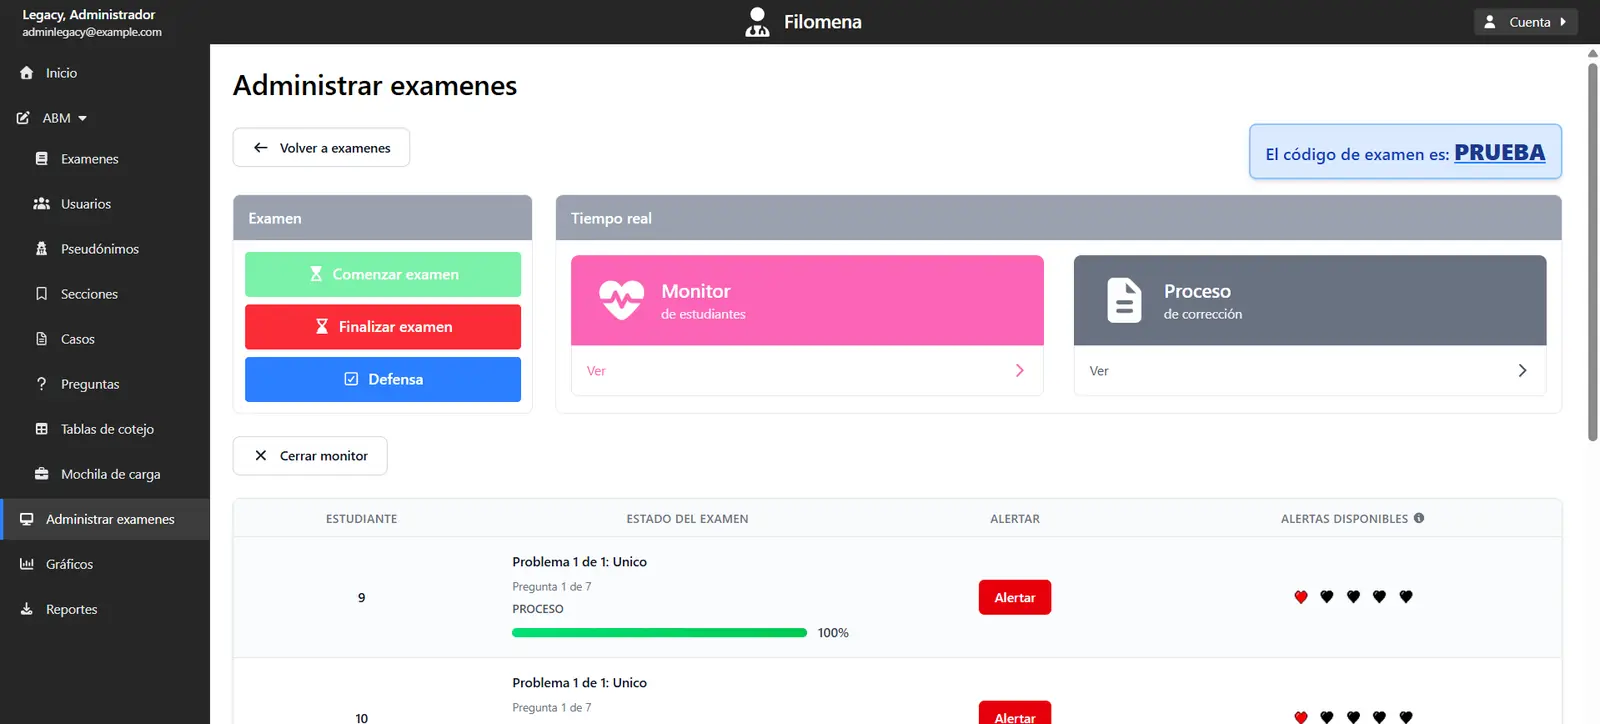
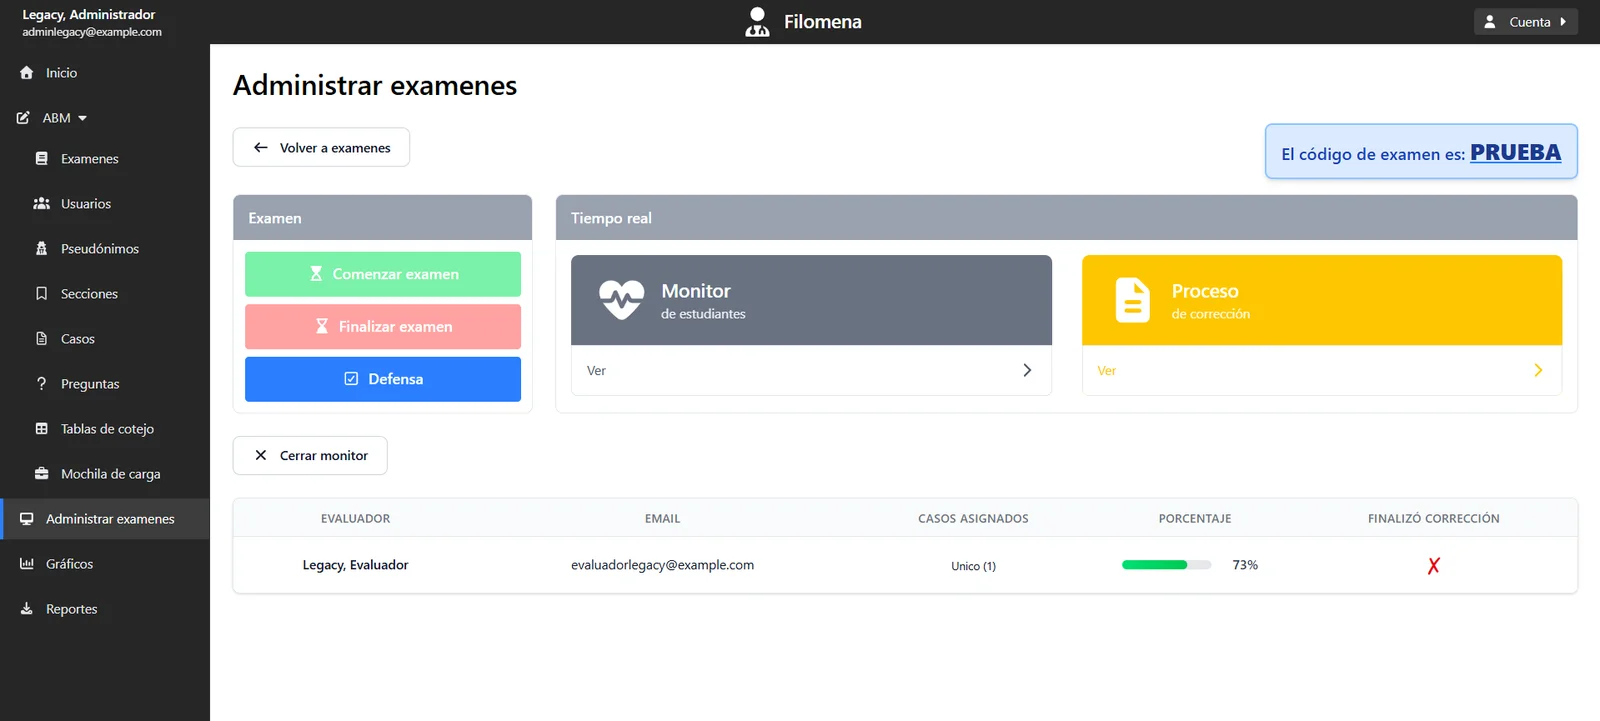
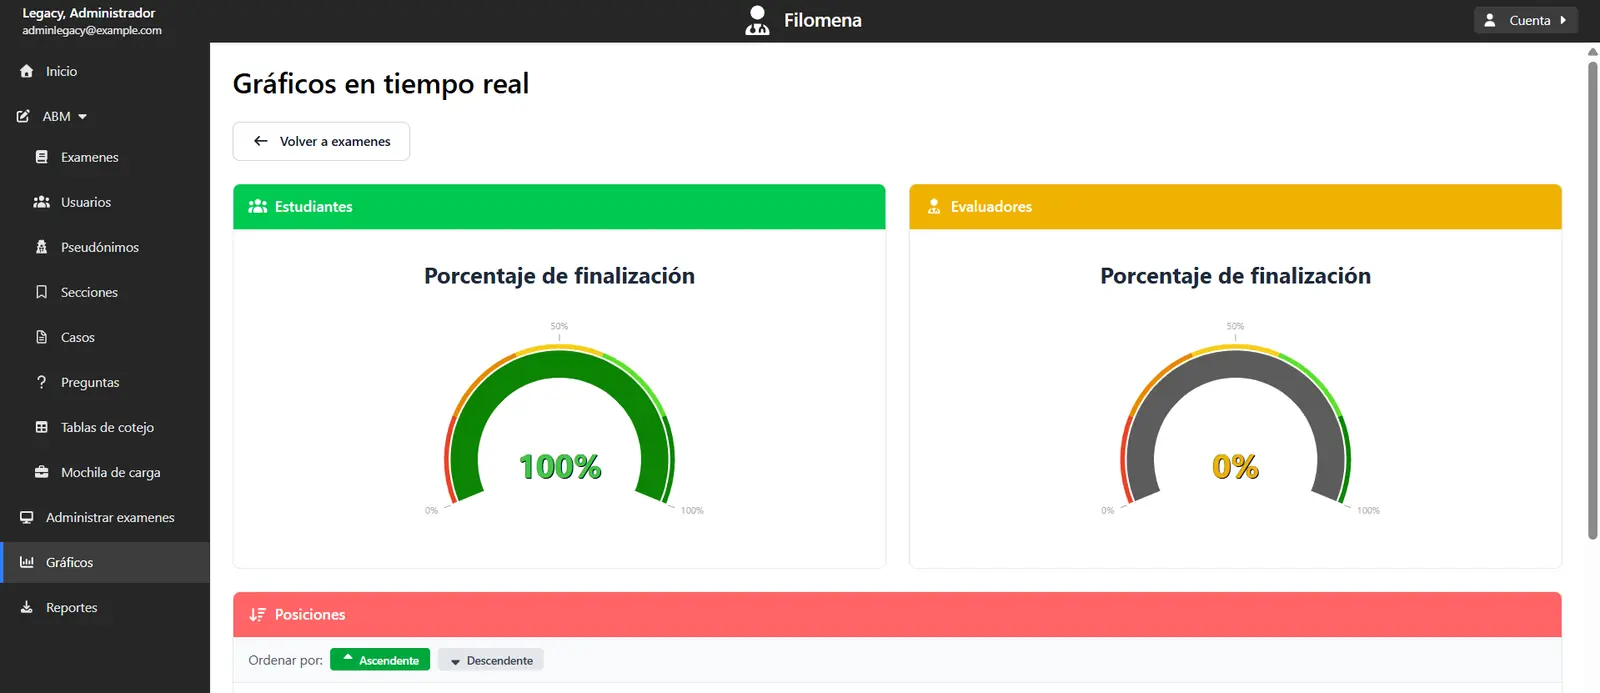
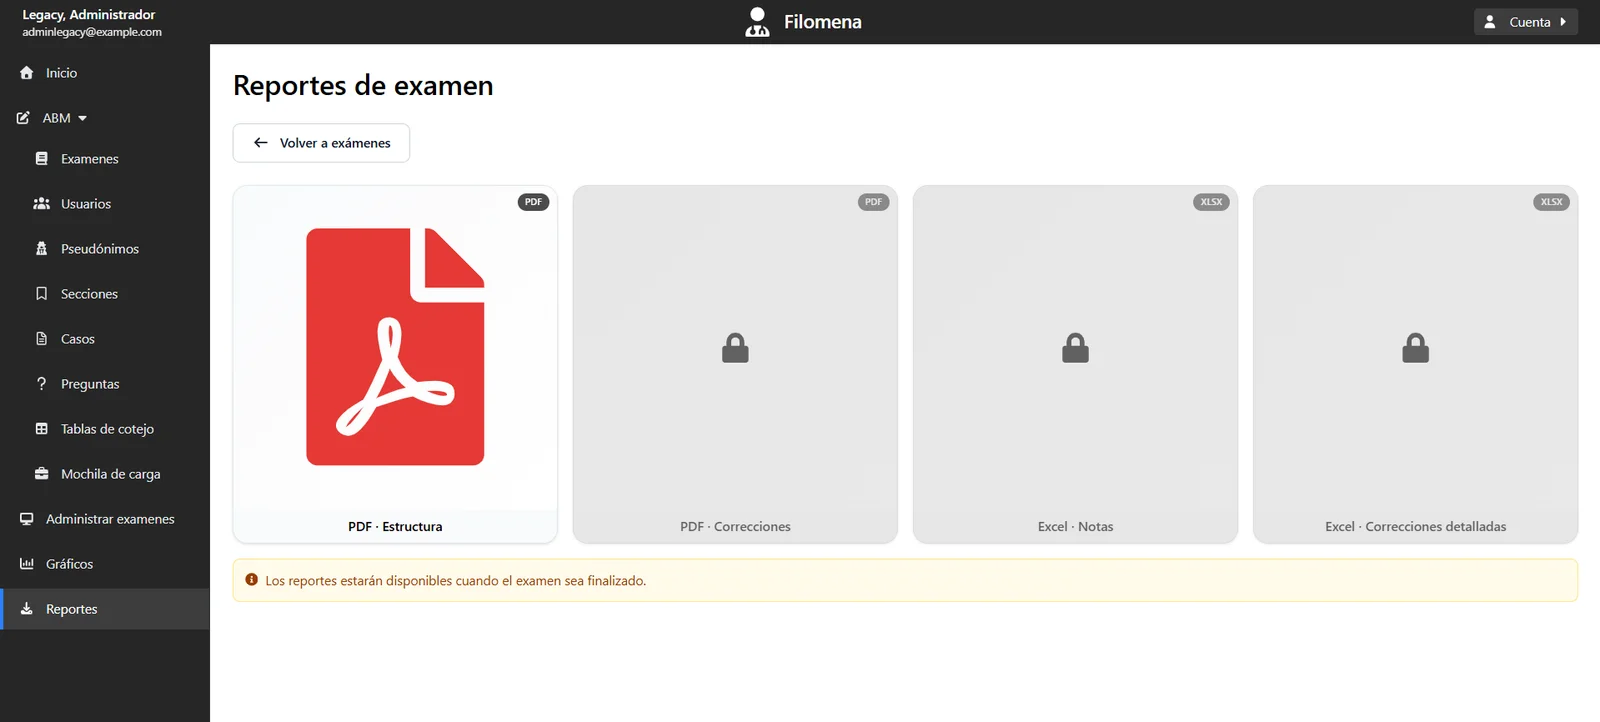
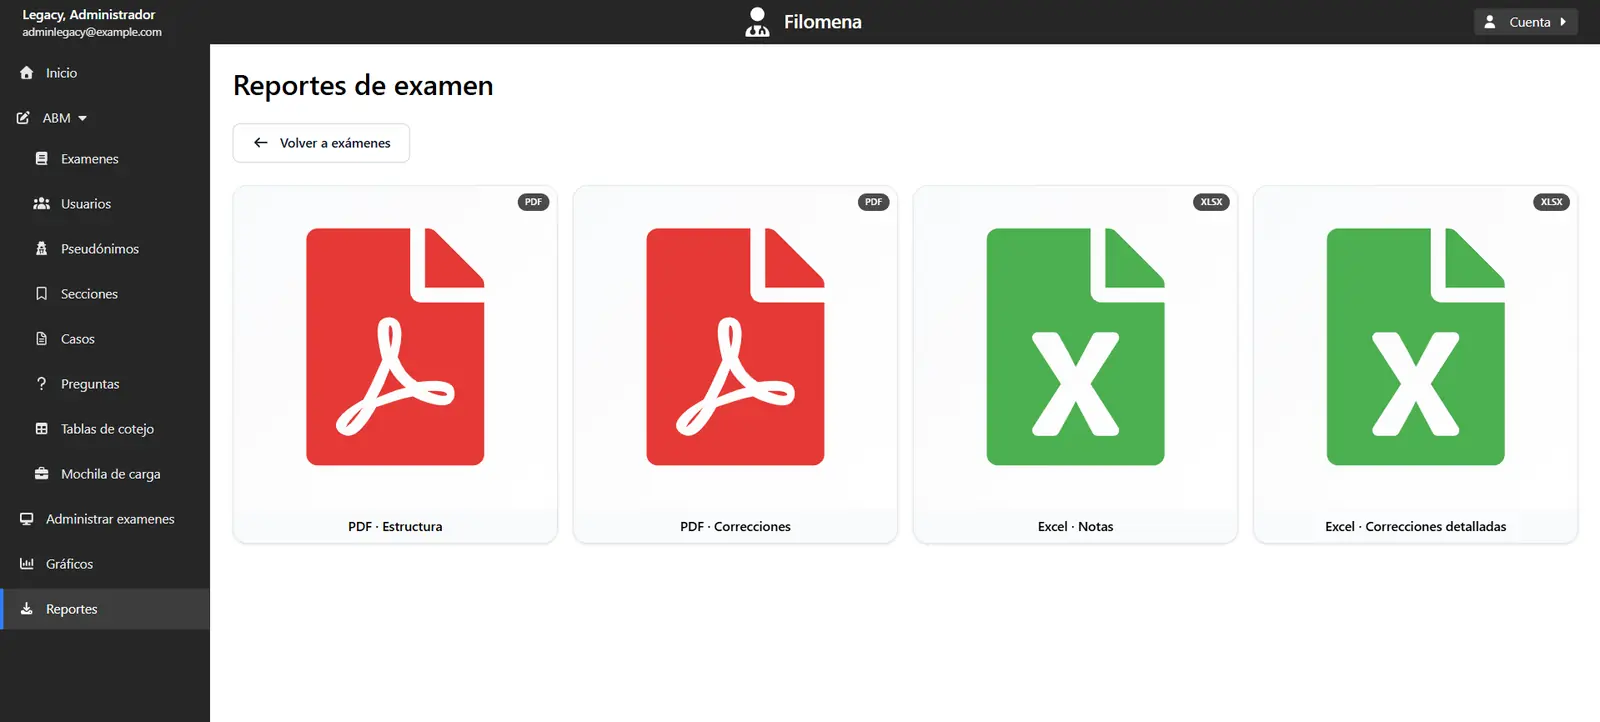
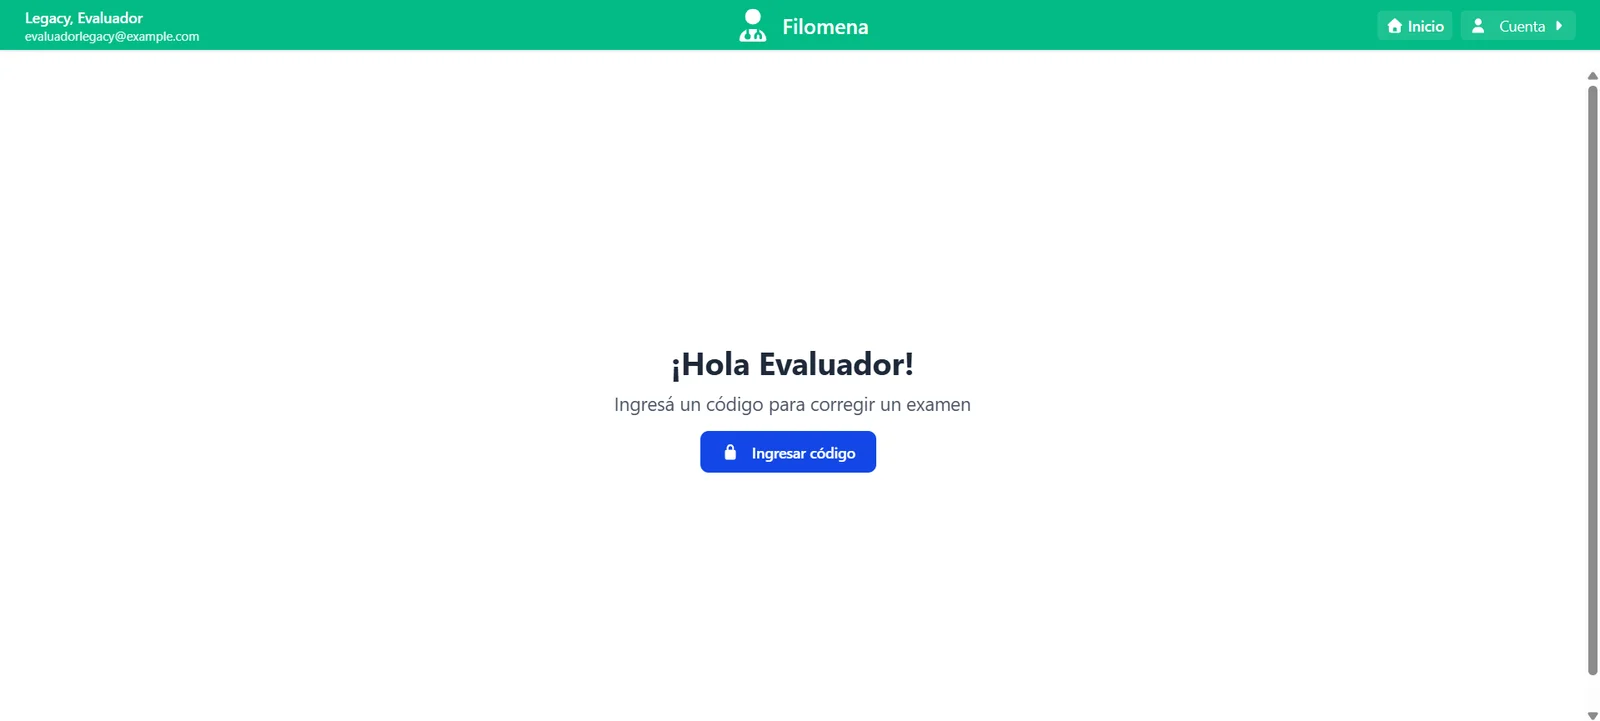
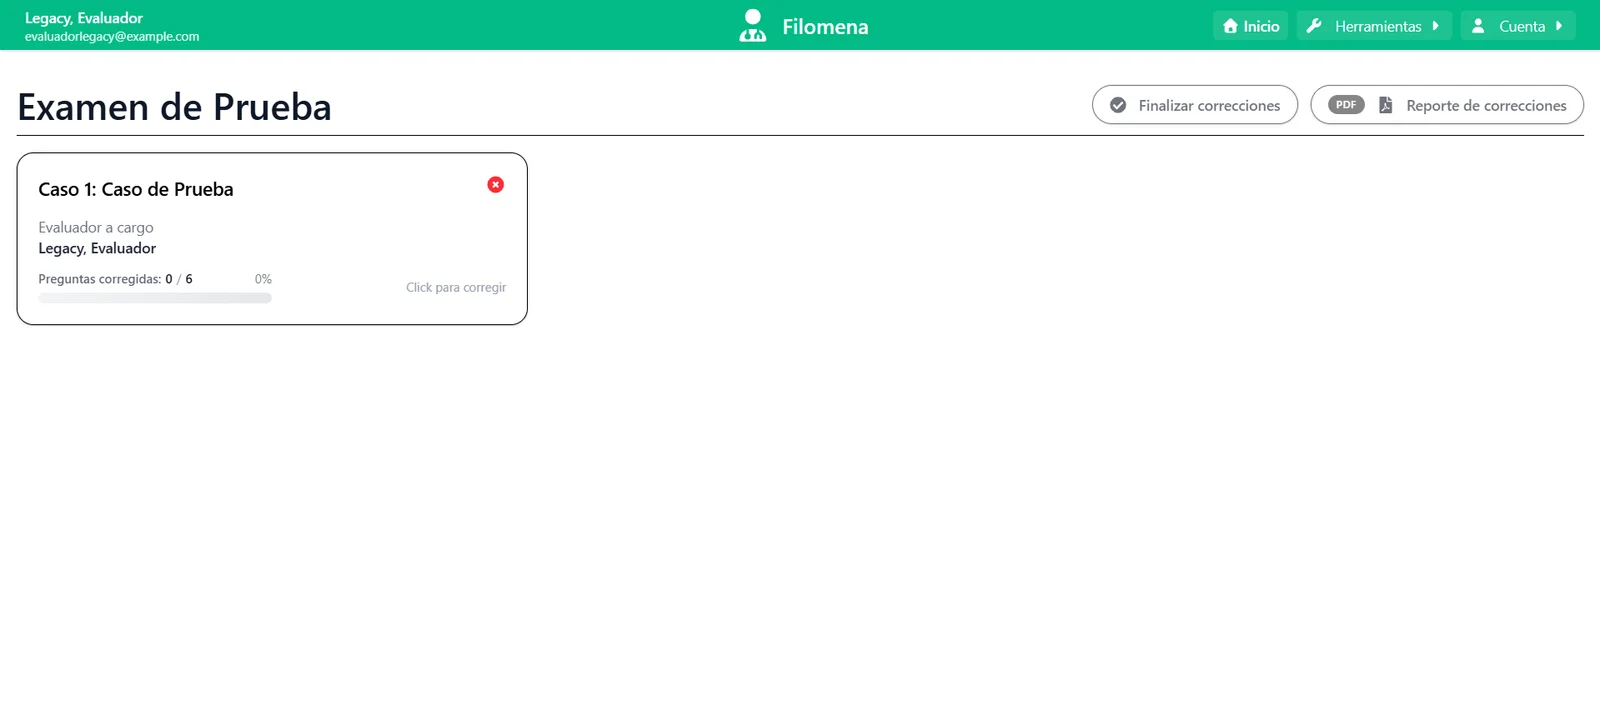
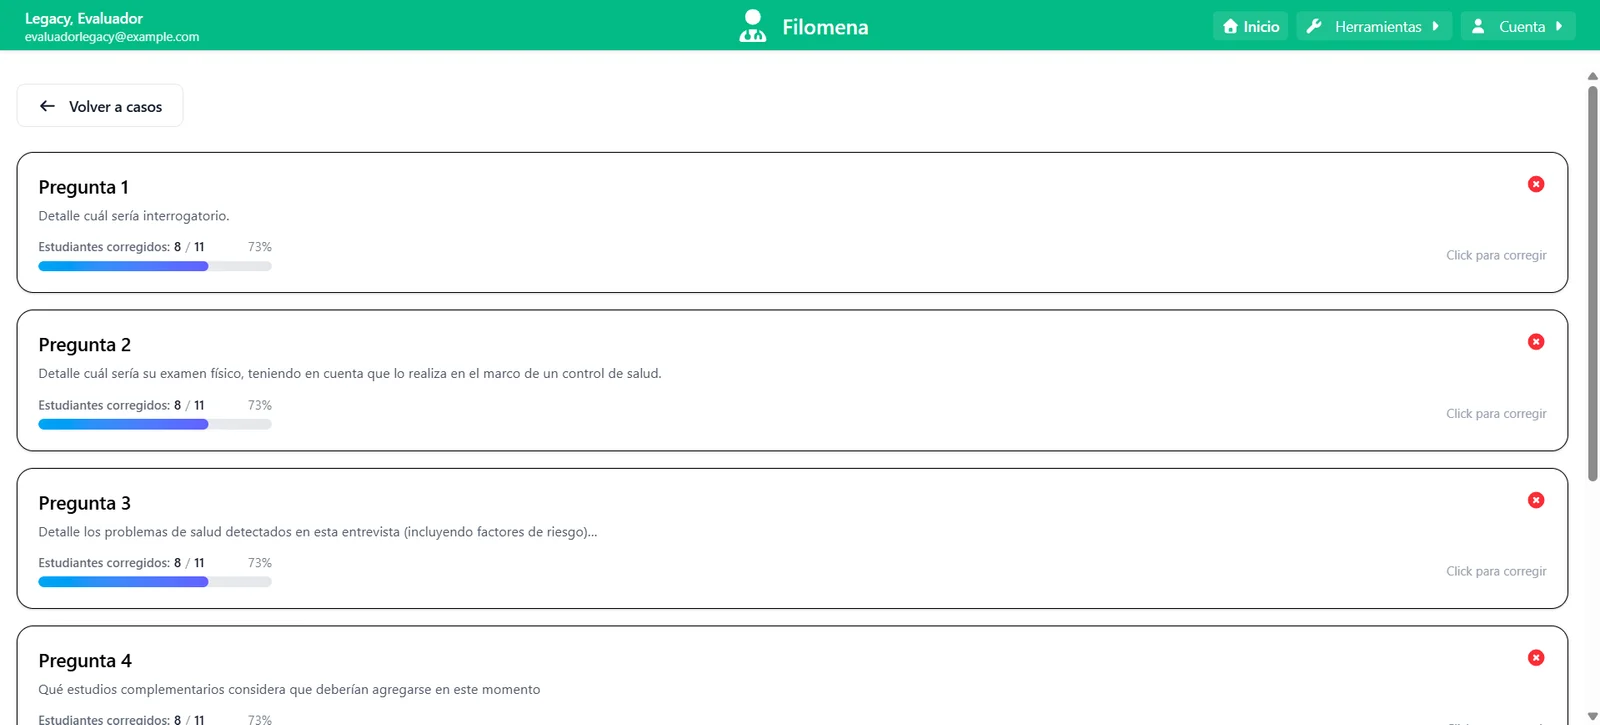
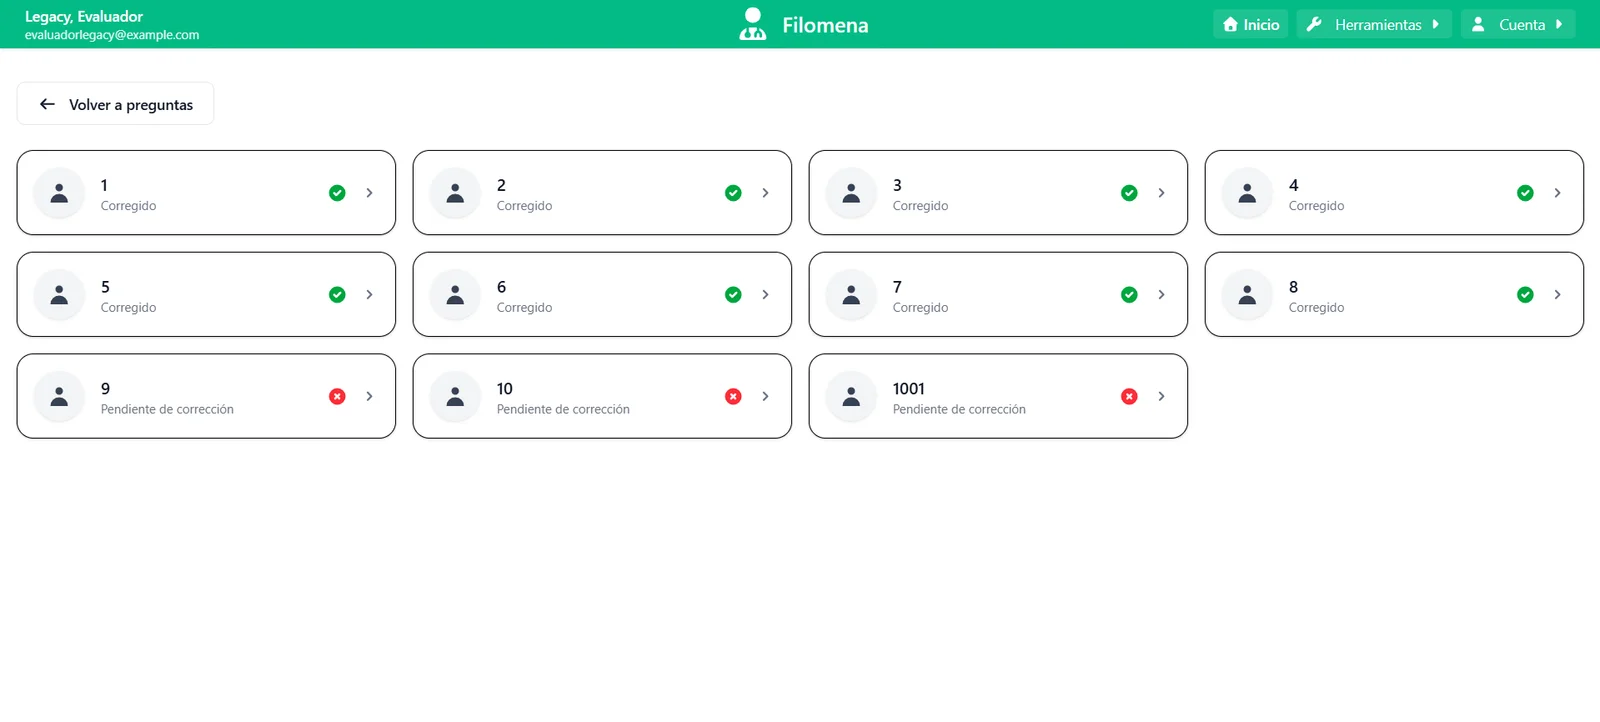
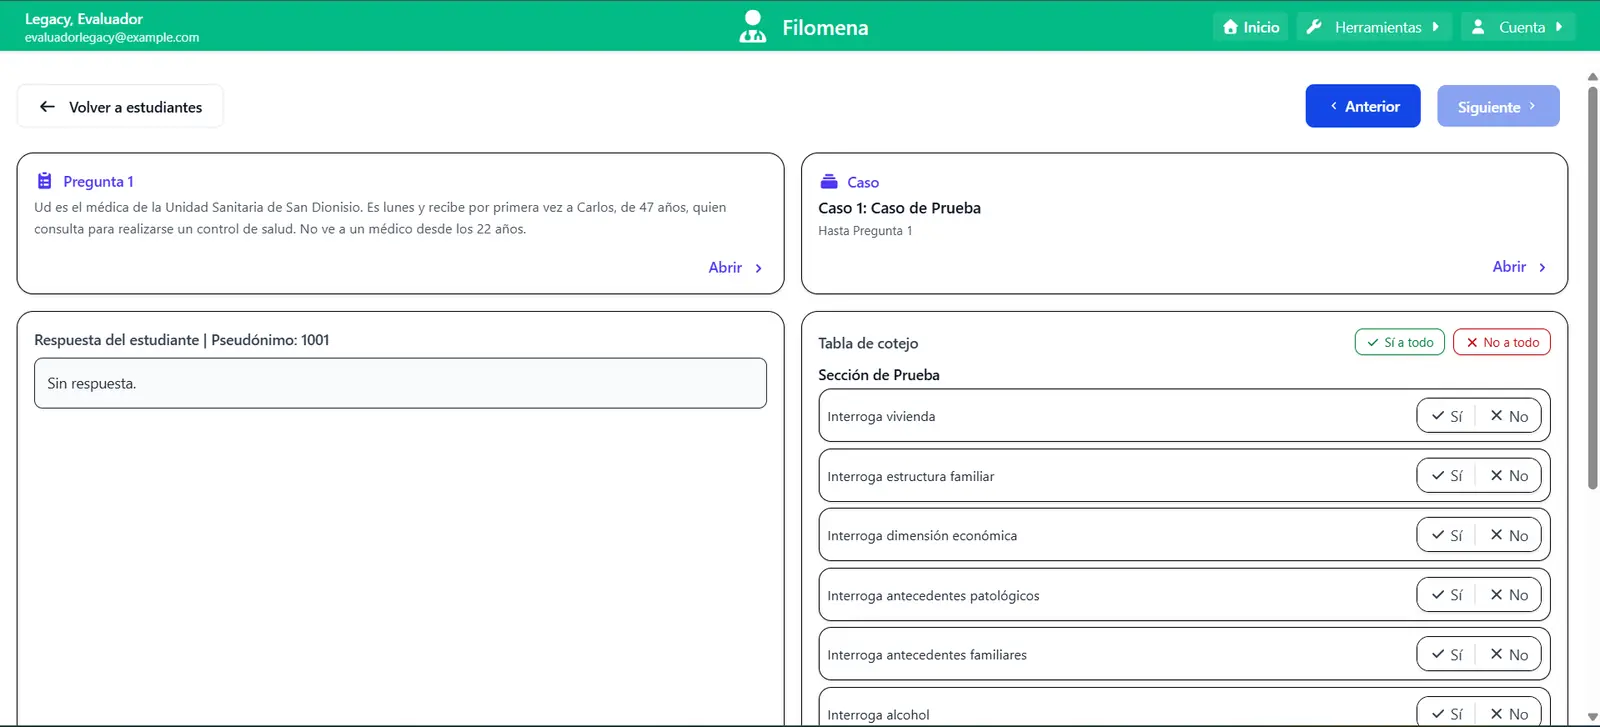
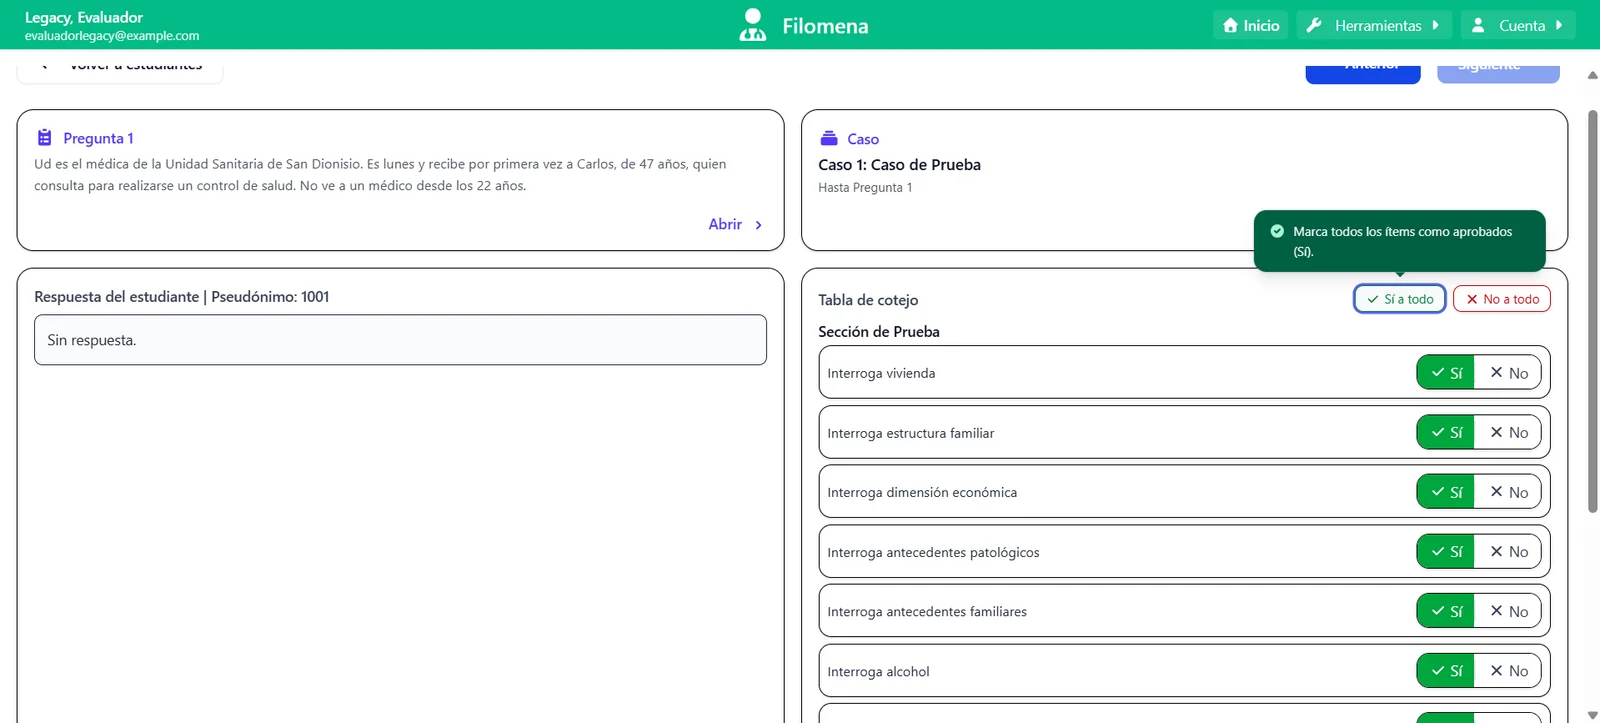
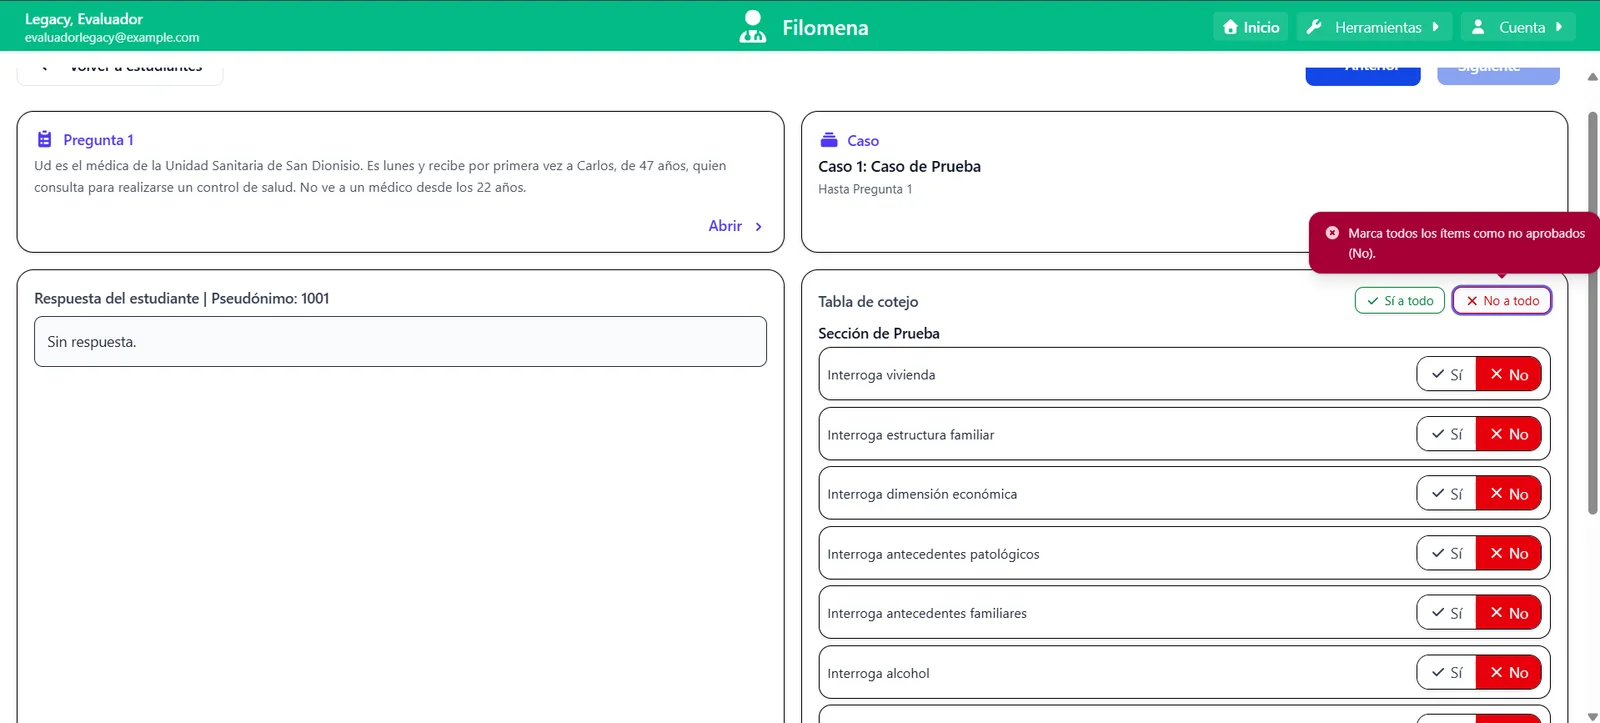
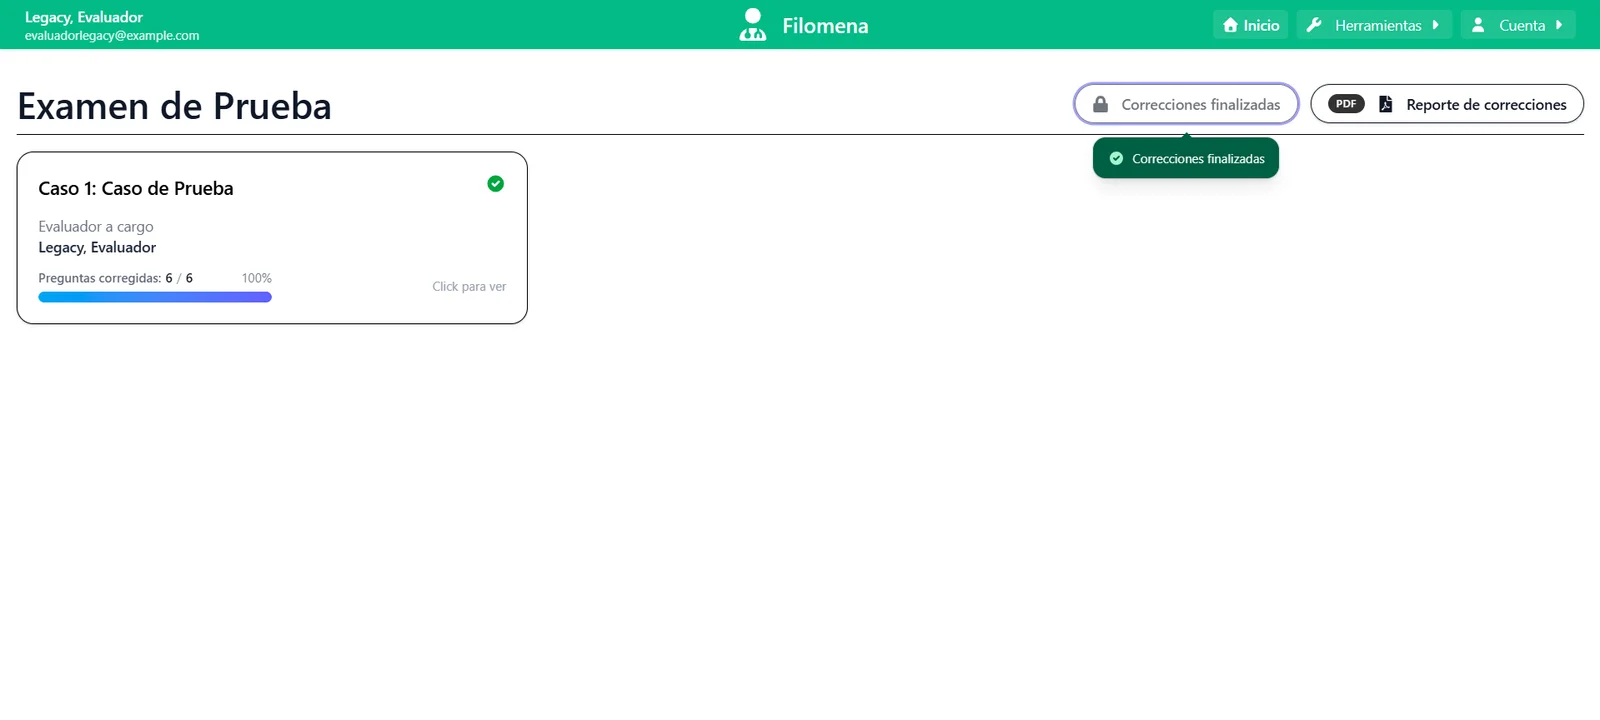
Los estudiantes son seudónimos para los evaluadores. El modelo de datos y la API aplican esa separación, manteniendo la identidad del estudiante fuera del flujo de corrección del evaluador.
Cada institución administra sus propios cursos, evaluadores, estudiantes, exámenes y cronogramas, con los datos aislados entre sí. Eso fue lo que convirtió el onboarding de una institución nueva de trabajo de desarrollo en configuración.
La API aplica el control de acceso basado en roles. El frontend refleja esos permisos para mostrar a cada usuario las acciones disponibles.
Prometheus y Grafana brindan visibilidad sobre el comportamiento productivo de la base de datos, Redis, las colas y los workers, con logging estructurado y health checks.
| Aspecto | Antes | Después |
|---|---|---|
| Arquitectura | Monolito CakePHP y jQuery | API REST Laravel con un frontend Next.js |
| Concurrencia | Toma secuencial, una sola institución | 1.000+ usuarios simultáneos, observados en producción |
| Latencia | Se degradaba bajo carga concurrente | Endpoints críticos por debajo de 300 ms en promedio |
| Onboarding | Requería trabajo de desarrollo | Configuración, en minutos |
| Control de acceso | Aplicado de forma inconsistente | RBAC multirol en API y frontend |
| Observabilidad | Ninguna | Prometheus y Grafana |
El equipo de tres personas utilizó prácticas Agile y Trello para coordinar requisitos, implementación y releases.
Docker y Docker Compose proporcionaron entornos contenerizados, mientras GitHub Actions ejecutaba despliegues a producción en menos de quince minutos, desde el push hasta producción. Los repositorios públicos son versiones del código y no incluyen el pipeline original de despliegue.
Filomena está activa en UNS, UNRN, UNC, UNVM y FAMFyG. La operación productiva mostró 1.000+ usuarios simultáneos con consistencia completa de datos y endpoints críticos por debajo de 300 ms en promedio, monitoreados con Prometheus y Grafana.
El proyecto final recibió 10/10 en la Universidad Nacional del Sur, además de entrevistas, cobertura universitaria y menciones de autoridades académicas.
En una próxima iteración priorizaría la cobertura automatizada de regresión para exámenes concurrentes y límites de permisos. Las versiones públicas contienen actualmente tests de humo del framework.
También conservaría escenarios repetibles de rendimiento junto a cada release para comparar cambios futuros con el comportamiento ya observado en producción.
El recorrido del producto y el contexto de ingeniería están incluidos en esta página. Los repositorios enlazados son versiones públicas del código: documentan la implementación, no el historial original de desarrollo ni el pipeline de despliegue.